Showing Posts From
Llm
 Xieisabug
- 21 Dec, 2025
2025.12 AI使用有感
不知道是不是因为AI真的陷入了瓶颈,现在的模型很少出现完美的,每个模型总是有一定的缺陷,这也就导致了用AI需要一些技巧,这些技巧让AI带来的智力平权又拉开了一点距离。 我有这个想法,最初是源于教老婆用AI,她之前用AI用的不多,在给她使用了Claude Code、Codex、Gemini CLI、Copilot等产品之后,她惊呼好用,但我观察她的使用总是觉得笨笨的,仔细总结之后发现用AI确实是需要一些技术和一些经验。 例如她喜欢非常简单的描述问题然后与AI进行非常多轮的讨论来明确整个需求,这导致AI的无用上下文大幅提高,AI在处理长上下文的情况下性能又会下降很多。 又比如她不喜欢切换模型,当我告诉她Opus4.5好用之后,所有的情况都是用Opus4.5来完成,导致一些比较复杂的逻辑性需求或者Bug改来改去无法完成,这种情况下使用Codex的ExHigh或者High才是最佳选择,虽然说可能思考十几分钟,但是问题基本上是能够修复的。 还比如最好别给AI用“你是XXX”,别跟AI提“我”,写界面最好提供设计截图,用Simple Browser来给AI提供DOM上下文等等等等。 这里面门道其实挺多,造成用AI的能力也有1-10倍的差距。
- Xieisabug
- 17 Jun, 2025
日常-阅读 How we built our multi-agent research system
今天抽空阅读了 Anthropic 的 How we built our multi-agent research system,其中有不少过去就已经了解熟知的知识,也提到了不少能够激发我思考的点,来总结总结。 首先先说说之前就了解的:一个非常聪明的规划者。Anthropic 用的自然是 Opus,规划任务、决策都是 Opus 来做的,越聪明的 AI 做规划者越能提高执行者的效率和效果,目前第一梯队的规划者只有 3 个,Anthropic 4-Opus、OpenAI O3、Gemini-2.5-Pro,排名有先后。执行者的能力不能太低。Anthropic 的执行者使用的是 Sonnet,而不是 Haiku,执行者要能正确的使用工具,正确的遵循格式来输出,并且最重要的是能够理解任务的要点。使用记忆。PreAct 的要点就是提前计划并且生成 TODO,需要记住 TODO 完成的状态;在每轮迭代任务的过程中,都会产生新的结果,都需要进行记录;长时间执行的任务,会产生巨长无比的上下文,通常经过总结后也需要保存到记忆中。文章中配了两张图都提到了 Memory 可以看出它的重要。 之所以不把记忆归类到工具,是因为记忆可以算作一个基础设施,是必须要使用的,而工具是根据任务的不同可以选择用或者不用。使用工具。给予丰富的工具才能让 Agent 的智能发挥作用,最近看的最典型的例子就是,ChatGPT 网页上的 O3 在工具加持下能够通过非常普通的照片定位到照片拍摄位置。过去我倾向于看模型的 Aider 评分来看模型的能力,因为这个评测集通常反应了模型编写代码和指令遵循的能力,但发展到现在的阶段,Aider 的评分已经无法反应出模型真正解决问题的能力,现在我更喜欢看模型的 SWE-bench Verified 评分,这是一个经过筛选的现实问题集,考验模型使用各种工具来解决现实问题的能力,不过通常强的模型这两者的分数都不会低。再来谈谈新的收获:巨量的 Token 消耗。Anthropic 提到 Multi Agent 是普通聊天的 15 倍 Token 消耗,所以应该让 Multi Agent 作用在能产生高价值的地方,而不是普通的任务。我之前有想过为什么 AI IDE 不搞一个这种 Multi Agent 模式,能够又聪明又快速的完成任务,从这篇文章中可以一窥原因,现在的 AI IDE 不约而同的让自己的工具在尽量少的 Token 消耗的情况下来解决问题,但基本都是事与愿违,有时候看着 AI 50 行 50 行代码的 read,真的哭笑不得。想必这就是 AI 提供商巨头的护城河,他们的 Token 基本上是 Free 的,通过烧 Token 来提高效果这是一般的应用公司没法做到的。Agent 调试。之前从没有想过来做一个工具像断点代码一样调试 Agent,Anthropic 做了一个工具,能够逐步的观看 Agent 如何进行处理,这使得在 Agent 优化的过程中能够直观的、不停的 减少 不必要的工具调用、生成冗长的搜索词等。这也让我想到了可以把 传统编程中的很多调试方法都带到 AI 应用开发,除了断点,还有像日志(做个 MCP 来让 AI 自动输出日志到指定的地方)、Mock(假设模型的前置返回或者 MCP 的返回来进行测试调试)等等,对于 AI 这种黑盒开发有不小的帮助。智能体自我进化。像 Cursor 中的 Agent 自动调用测试获取报错信息或者是获取 Lint 报错一样,如果任务执行的不好,Anthropic 会让 Sonnet 自己来修改提示词再次进行尝试,直到获取到更好的结果。甚至当提供的 MCP 工具有问题时,Sonnet 会去修复这个工具然后继续。之前看信息流里有 OpenAI 的老哥说 O3 的降价也来自于 Codex 对系统的自我进化开发。这相当于强化学习训练出来的 AI 来用强化学习的方法来训练一个应用?并行处理。不光是把任务分解后多个 Agent 同时去完成所有的任务,还有 Agent 同时调用多个工具来解决一个任务。这个想法其实我之前也想到了,并且在一个 Side Project 中也实践过了,效果非常好,这个 Project 是一个小说编辑器,在对小说进行润色的过程中,会让规划者先标记出来哪些句子需要润色,再让多个执行者并行的对每个句子来进行润色。原来这个任务在润色一篇 3000 字的文章时,起码要等待 40 秒(使用的是 gemini 2.5 pro),使用了这种方式之后,大约 10 秒内就能看到结果了。提示词优化。Anthropic 提到一个微小的提示词修改,使得任务成功率从 30% 提高到 80%,这让我想到之前听的播客中的一个观念:如果我修改16 次提示词最终完成了比较难的问题,那么这个过程中,到底是我太菜了还是 AI 太菜了?Anthropic 很大方的开源了自己的提示词,可以去 Anthropic 的仓库里看看。工程化。Anthropic 提到了很多工程化的问题,包含了 恢复状态、容错、可调试可观测可测试、部署更新、执行与并发 等各种挑战,这也是每个做 AI 应用的开发者都可能会碰到的问题,所以 AI 应用并不是写个提示词那么简单,涉及到的编码和传统软件工程的知识都非常多。在目前,至少是 2025 年 6 月这个节点,根本不可能有真的0编程知识的人能够使用 AI 开发上线运营一个应用。想法: 我曾经花了一个小时,和 AI 对谈让它来不停的问我问题了解我,最终总结出了一大篇关于模仿我的提示词,然后我就可以与“我”对话了。不过这个“我”的上下文还是太少,比如我正在写的项目和完成的进度,比如我的朋友同事们的性格和我们之间的经历,比如我还有一些并不符合 AI 政策的想法无法输入进去。同时“我”的能力还是太少了,抛开能影响现实中的能力不谈,在电脑中的能力也少的可怜,虽然我也配置了很多 MCP 但 AI 任然不能用我的电脑做任何事,比如聊微信、写 Word、刷信息流等等。但如果我提供了某个特殊领域的所有工具,比如程序员或者产品经理,它能够写代码、执行命令、获取错误、截图看效果、写 Markdown 文件、发飞书通知、查看禅道 Bug 情况、跟进飞书多维表格的任务进度,那他是不是真的可以成为某个领域中的我,然后再用 Multi Agent 技术来模拟许多个我,让我的效率得到千百倍的提高。这件事我会去做,不过估计做的会比较慢,我相信随着模型智力的提高,最终的那个“我”肯定比现在的我要更胜任我的工作,那时候我应该可以躺着了。 最近一直被安利 Claude Code,不过没抽时间去试,昨天偶然看到了一个 MiniJinja 的作者使用 Claude Code 修复现实中的 Issues 的视频,可以看到的是,Claude Code 并不能真正“完美”的完成任务,改动的方案并不是最佳的,也没有遵循用户的指令先进行方案讨论不要立马实现代码,修复这两个 Issue 都是需要资深开发者来介入的。所以我一直偏向 Cursor 这类 AI IDE,纯 Agent 很容易把原来优雅的代码改成屎山,然后又要花时间去把屎山做优雅。不过如果是 Vibe 一个简单的 Side Project 用这种方式应该还是很舒服的,等我下一个 Side Project 启动的时候我会开一个 100 刀的 Claude Code 试试。
- Xieisabug
- 03 Jun, 2025
LLM-大模型价格榜
之前一直在看的大模型价格榜在去年停止更新了,导致我有时候做产品的时候或者偶尔要查大模型价格的时候特别不方便,所以我自己 vibe 了一个: https://llm-price.xiejingyang.com/ 数据来自 litellm 的 模型价格定义json 和 deepresearch + 手动整理,我会尽力保持更新功能和维护数据的。如果数据有问题,也请给我留言或者联系我。
- Xieisabug
- 25 Mar, 2025
LLM-大模型绘制流程图
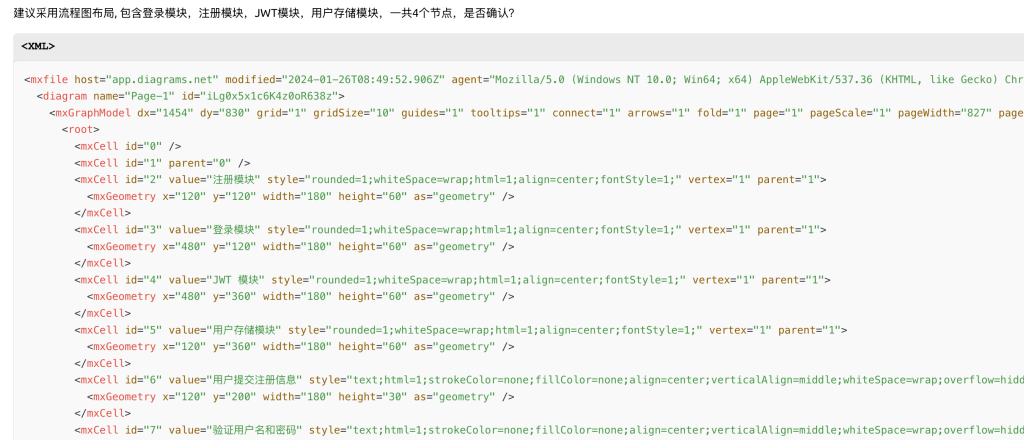
过去在读代码的时候或者是学习的时候,经常让大模型给我画流程图,一直是用的 mermaid 的方式来绘制,使用这种方法的好处就是大模型基本上都会,因为 mermaid 算是非常有名的 markdown 中展示流程图的方案了。 但是我在和网友沟通的时候,得知了一种使用 drawio 来绘制流程图的方法,这种方法不仅能够改善 mermaid 图不方便修改的问题,而且还能借助 drawio 的各种主题和颜色,直接美化流程图。输出大概如下:存为文件在 drawio 打开的效果如下:如果使用 mermaid 是这样的:网友是在小红书中看到的,但目前好像被删除了看不到了,我这边贴一下我从小红书中拿到的提示词: 你是一个卓越的绘图高手,你需要根据用户的需求来进行绘图。 **核心能力:** 1. 根据视觉描述/需求直接生成可运行的draw.io代码 2. 校验机制保证代码准确性 3. 输出标准化代码块**处理流程:** ① 接收输入→ ②要素解析→ ③结构建模→ ④语法生成→ ⑤完整性校验→ ⑥输出结果**输出规范:** ```xml [生成的核心代码]...交互规则:收到图片描述时: "正在解析结构关系(进行描述图片细节)----(校验通过)" 收到创建需求时: "建议采用[布局类型], 包含[元素数量]个节点,是否确认?" 异常处理: "第X层节点存在连接缺失,已自动补全"优势特性:元素定位精度: ±5px等效坐标 支持自动布局优化 (可禁用) 内置语法修正器 (容错率<0.3%)DrawIO 图形规范指南 drawio文件是基于mxGraph的XML结构 基础要求 • 展示在A4纸上,选择合适的字体大小 • 字体必须全部加粗,标题等关键元素字号加大处理 • 线段统一使用3pt宽度,保证在论文打印后依然清晰可见 • 所有文本格式(加粗、下标上标、公式代码)必须正确实现 • 使用标准drawio文件格式,保证兼容性 • 组件必须完全容纳文字,避免文字溢出 • 所有线条必须设置jumpStyle=arc和jumpSize=6,确保交叉处清晰可辨 • 所有连接线拐点必须设置 rounded=1保证美观 布局规范 • 组件间垂直和水平间距保持统一 (30-50px为宜) • 将相关的组件放入容器或组中,以提高图表的可读性和组织性。 • 对齐方式使用center,保持一致性 • 使用网格对齐(gridSize=10)辅助布局 • 避免组件和连接线重叠,特别是避免线条穿过文字 连接线规范 • 所有箭头样式必须统一 (endArrow=classic) • 多条连接线汇入同一组件时,应从不同方向进入(如左、中、右) • 同一起点的多条连接线应适当分散起点位置 • 为所有交叉的连接线添加跳跃样式(jumpStyle=arc) • 长距离连接线应适当设置航点 (waypoints) 引导路径 • 绝对禁止连接线遮挡文字和组件标签 组件连接设计 • 组件使用浮动连接点,而非固定连接点 • 相关组件应放置在合理的相对位置,减少连线复杂度 • 复杂流程应分层次展示,避免连线交叉过多 文本与组件规范 • 所有组件内文本必须加粗(fontStyle=1) • 数学公式使用HTML格式: hv和hinter 不要使用latex格式 • 公式可以根据条件更换字体 • 数学符号如点乘必须使用正确格式: 应写为⊙ • 合理使用waypoints:在需要精确控制连接路径时,可以使用固定的waypoints来避免线条交叉和文字遮挡 • 组件大小应根据内容自适应,保持适当留白 命名与结构规范 • diagram name必须命名为有意义的名称 (如“多模态特征融合流程”) • 组件ID必须反映其功能(如query-network) • 连接线ID应反映实际连接关系(如edge-visual-query) • 相关元素应放在一起,提高代码可读性 实践检查清单 • 连接线交叉检查:所有交叉处是否设置了jumpStyle=arc • 文本遮挡检查:是否有连接线穿过文本或遮挡组件 • 格式一致性检:字体、线条宽度、箭头样式是否统一 • 连接美观性检查:连接线是否从合适的方向进入组件 • 留白空间检查:组件之间是否有足够间距 (30-50px) • 代码健壮性检查:代码是否符合drawio开发规范,是否可以运行 特殊场景处理 • 复杂图表应考虑分层或分区域展示 • 多条平行连接线应保持一致的间距和样式 • 长路径连接应使用中间节点或分段处理 • 双向连接使用两条独立的连接线而非双向箭头 参考资源 • DrawIO官方文档: https://www.drawio.com/ • DrawIO学习教程: https://www.drawzh.com/ • 在线编辑器: https://app.diagrams.net/ • MXGraph语法: https://jgraph.github.io/mxgraph/docs/tutorial.html也许还可以简化,但是我懒得简化了,这样反正能用,效果也还挺不错的。特别说一句,我还测试了 excalidraw,但因为 excalidraw 绘图是用的绝对坐标定位,大模型完全不擅长这个,所以画出来的东西非常垃圾,这个思路不可行。drawio 如果仔细看他的绘制方式,都是使用的 id 引用,所以流程都是相对的,很适合大模型输出。要是哪个客户端能够直接嵌入个 drawio 展示就好了。
- Xieisabug
- 07 Mar, 2025
工具-Copilot 的更新
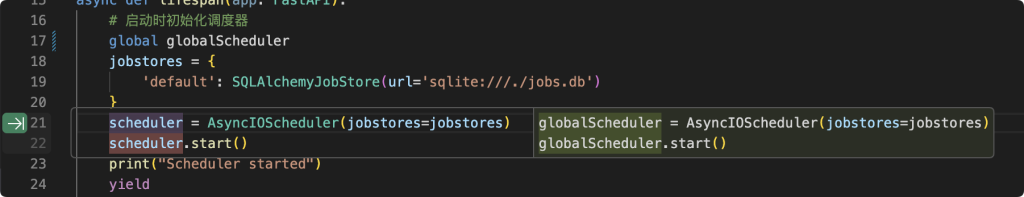
最近从 Windsurf 切回 Cursor 又切回 Copilot 了,一是对 AI 越来越了解,交给 AI 的活越来越多,导致积分制的 AI 根本不够用,二是 Copilot 现在也上了御三家所有的前沿模型想要试试,三是我一直有 Copilot 的资格只是之前嫌弃它。 首先说感受,我觉得我不用买 Cursor 了(不代表别人不用)。 他目前更新了以下几个方面,我觉得完全可以平替 Cursor,然后不限量的这个特点又非常适合我。 Tab Tab TabTab 是我一直以来觉得 Copilot 被吊打的部分,现在 Copilot 也有多次 Tab 提示了,和 Cursor 体验有一点差距,主要是速度不如 Cursor,但是当个代餐其实够了。Agent 和 Cursor 的 YOLO(You only look once) 一样,会根据要求自动的去完成任务,发现不能理解的地方也会自动去阅读代码,会规划任务并且一步步的去执行和更新任务状态。碰到要执行命令的情况,也会弹出提示要求授权执行,命令碰到报错还会自动解决。并发更新 这是今天发现的,他在编辑代码文件的时候,并发编辑了好几个文件:29 个文件大概十几秒就改完了,以前用大模型来编辑代码基本上就是我的尿点,三四个文件的编辑就要花上几分钟了,现在感觉无尿点了(当然咯,可以看到我的修改确实也很简单,就几行代码需要修改)。 模型的选择 这个还是挺重要的,能用最好的模型对于代码质量是最好的保障,不过 Copilot 的模型应该不是最高算力,或者被内置提示词影响了,但是绝对是没有掺假(我用智力提测试过了 o1 和 o3):内置了 Code Review 和 Commit Message 生成 这个好像别的编辑器也有,不过 Copilot 这个不限量用起来没啥负担,我几乎是每次提交前都会让 AI Code Review 下。还有什么你觉得 Cursor 是无法替代的?
- Xieisabug
- 26 Sep, 2024
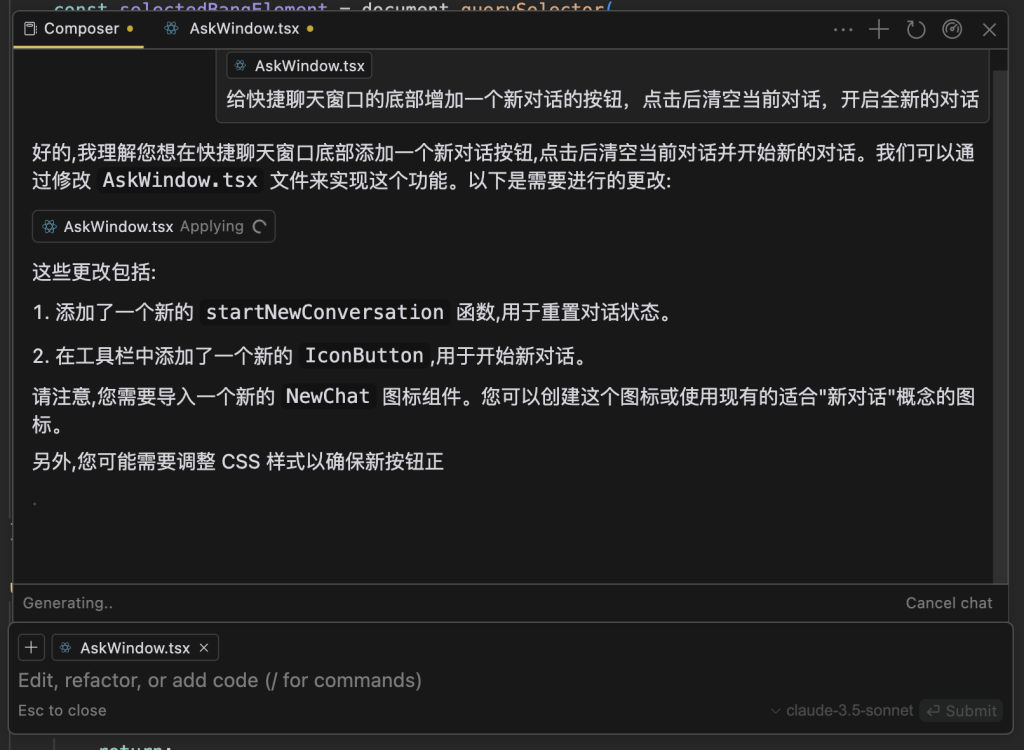
Cursor Composer、Zed Workflow、Aider、Copilot Workspace对比
本文只是对四款自动编码的产品做一个横向比较,单独的产品使用评测可以看看博客里单独评测的文章。最后有AI生成的对比表,省流的可以看每个对比的结果和最后的表。 并且该横向评测的结果也只是我自己日常使用的主观感受,每个人的场景不同自然会有不同的体验。(叠甲 选手简介Cursor Composer:Cursor Composer是一款集成在Cursor编辑器中的AI自动化编程工具。它能够根据用户的需求描述,自动分析项目代码,并生成相应的代码修改方案。Cursor ComposerZed Workflow:Zed Workflow是Zed编辑器的一个功能,允许用户通过提示来指导AI进行代码修改。与其说它像Cursor Composer,不如说是Github Copilot Chat的增强版。Zed WorkflowAider:Aider是一个命令行工具,可以与多种AI模型配合使用。AiderCopilot Workspace:Copilot Workspace是GitHub的扩展功能,目前只能通过Github Next提供的Web界面使用。它可以分析GitHub Repository,然后根据用户输入的需求生成解决方案,并直接修改代码。Copilot Workspace 用于评测的项目是我编写的一个开源大模型客户端:https://github.com/xieisabug/tea 对比维度 我会针对以下几个维度来进行体验对比:工程能力代码质量用户体验价格与性价比详细对比 工程能力Cursor Composer:能根据需求自动识别出需要修改的文件、能够多轮次的迭代修改、能够选择是否应用单个修改,实际体验下来识别需要修改的文件不是非常的准确,并且使用的过程中还碰到了找不到历史记录或者修改文件失败之类的小bug。Zed Workflow:工程能力很弱,需要手动提供上下文文件给AI,修改也需要自己去一个个点Transform按钮,而且不知道是不是因为格式过于复杂,Deepseek有时候会无法遵循格式导致这个Workflow没法用。Aider:同样能根据需求自动识别出需要修改的文件、能够多轮次的迭代修改,修改会直接应用到文件上,通过git的能力来查看本次修改和回退修改。特殊的是aider具备出色的自检和自纠错能力,能自动运行测试用例并确保通过。Aider使用Deepseek也偶尔会出现没有遵循格式修改,但是Aider会自动让Deepseek重试。Copilot Workspace:同样能根据需求自动识别出需要修改的文件、能够多轮次的迭代修改,能在网页上用diff格式展示出所有的修改,特殊的是它在输入需求之后提供分步骤的需求分析、代码分析、代码修改计划,有助于处理复杂任务理清思路,能够直接提交到Github Repository,也能通过最新的一个VS Code插件来同步修改到本地运行测试。Aider > Copilot Workspace = Cursor Composer >> Zed Workflow 代码质量 本来不应该在评测这种大模型工具的场景下,评测代码质量,因为代码都是模型写的并不是这些工具提供的能力。但在我使用的过程中,由于Prompt、工具限制等各种情况导致代码的质量还真有一些不同。Cursor Composer:能用GPT和Claude之类的SOTA模型,也可以用自己的key,但是要转换为Cursor“认证”过的模型,也就是把模型名字要改成gpt4o之类的,我就是把deepseek用worker覆写成gpt4o来使用的。Zed Workflow:纯纯的就是靠模型能力了。Aider:得益于其强大的自我纠错和测试运行能力,代码质量最佳。支持几乎所有的模型,并且有一套自己的榜单Aider leaderboard和测试集,有钱的大哥可以体验体验用o1 preview自动写代码的快感。Copilot Workspace:可惜只能用GPT(居然变成了减分项),有Copilot写代码的通病,喜欢吞括号和分号。现在可以申请o1系列的模型了,我还在waitlist里等着。Aider = Cursor Composer > Zed Workflow > Copilot Workspace 用户体验Cursor Composer:集成在编辑器中,使用便捷直观,和聊天是用的同一套UI体系,一方面来说比较稳没有什么学习成本,一方面来说又太稳了不突破很难有惊艳的效果。也许就是因为Cursor的这个稳让新入场的开发者都能非常快速的感受到它的能力。Zed Workflow:学习曲线也低,毕竟没啥东西。Aider:对于熟悉命令行的开发者体验还是不错的,与终端的结合度高,可能是因为不需要操心界面的原因,功能的完成度也非常高,基本上该有的命令该有的提示该有的检查全部都做到了,并且减少了对鼠标的依赖。但是学习曲线较陡峭,需要一定时间来“学习”使用这些功能,会用和不会用简直就是两种体验。Copilot Workspace:也是直观的界面且易于使用,但是其功能是独立于IDE的,所以使用的时候总是要切换来切换去。允许用户调整AI生成的分析和计划,可调整的空间很大。没什么学习的东西,基本上也就是一个输入框用来提需求就完事了。Cursor Composer > Copilot Workspace > Aider > Zed Workflow 价格与性价比Cursor Composer:必须开通Cursor Pro才可以使用这个能力,然后只有500次高级模型的使用权限,所以500次之后就得用自己的key来使用Composer功能。价格是20刀,不过20刀里还有Cursor的补全服务,这个补全服务我觉得比Composer值钱。不过我觉得20刀换500次高级模型使用+补全,还是不太值 (经过网友指正,不是500次高级模型,是500次快速的高级模型,之后应该还是会有可排队的高级模型使用),20刀买api能用很久了,尤其是带有缓存命中的Claude和Deepseek(Deepseek 20刀能用一年吧,能不能提高点价格然后加加速啊)。Zed Workflow:有自己的Zed AI服务,但是暂时没收费,也可以用Copilot提供的GPT4o,这点还挺好,目前推荐用这俩,因为Zed的机制导致它使用的时候会消耗很多Token,如果没有缓存命中机制的提供商用起来会破产,除了Zed AI和Copilot之外最好就是用Deepseek了。Aider:工具本身免费开源,需要付费的是大模型的API。同样,使用缓存命中机制的提供商会便宜很多。Copilot Workspace:价格性价比优秀,尤其对于已经使用GitHub和Copilot的开发者。目前还不用额外订阅,暂时只需要Copilot的10刀。Copilot Workspace > Aider = Zed Workflow > Cursor Composer 总结对于需要强大工程能力和高质量代码输出的开发者,Aider 是一个很好的选择,Aider是一个长板很明显短板也很明显的工具。暂时还不推荐Zed Workflow,就算是结合Zed AI的各种能力和插件来使用,也达不到很好的效果,可以再让它发展一段时间。Copilot Workspace 对于目前拥有Copilot,并且维护了开源项目的开发者,非常友好,暂时没有额外的收费并且用户体验做的很好。对于那些希望在熟悉的VS Code环境中获得自动编码辅助的开发者,Cursor Composer 是一个不错的选择,并且因为其高结合度,操作非常便捷。目前这类的产品我最终还是找到了使用场景,最初我认为:复杂的任务无法完成、简单的任务用它完成徒增复杂度,现在我认为:复杂的任务拆解成简单的(这是我的能力)、经过多次与AI配合熟练后简单的任务让AI来做,我和AI配合起来还是很节省时间的。对比表 同样,最后让AI出一个表格 特性Cursor ComposerZed WorkflowAiderCopilot Workspace工程能力⭐⭐⭐⭐☆⭐☆☆☆☆⭐⭐⭐⭐⭐⭐⭐⭐⭐☆代码质量⭐⭐⭐⭐⭐⭐⭐⭐⭐☆⭐⭐⭐⭐⭐⭐⭐⭐☆☆用户体验⭐⭐⭐⭐☆⭐⭐☆☆☆⭐⭐⭐☆☆⭐⭐⭐⭐⭐价格性价比⭐⭐⭐☆☆⭐⭐⭐⭐☆⭐⭐⭐⭐☆⭐⭐⭐⭐☆自动文件识别⭐⭐⭐⭐☆⭐⭐☆☆☆⭐⭐⭐⭐☆⭐⭐⭐⭐⭐复杂任务处理⭐⭐⭐⭐☆⭐⭐⭐☆☆⭐⭐⭐⭐☆⭐⭐⭐⭐⭐自我纠错能力⭐⭐⭐☆☆⭐⭐⭐☆☆⭐⭐⭐⭐⭐⭐⭐⭐☆☆模型选择灵活性⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐☆☆☆☆版本控制集成⭐⭐⭐☆☆⭐⭐⭐☆☆⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐学习曲线⭐⭐⭐⭐⭐⭐⭐⭐⭐☆⭐⭐☆☆☆⭐⭐⭐⭐☆ 注:⭐⭐⭐⭐⭐ 表示最佳,⭐☆☆☆☆ 表示最差
- Xieisabug
- 23 Sep, 2024
工具-Copilot Workspace
不久前获取了Copilot Workspace的权限,一直没时间做测试,最近写了一个大模型工具客户端,刚好用这个开源项目来做下实验。 可以通过Github上的Issue触发(AI自动改简单的bug和完成简单的需求现在就实现了?),也可以直接在网页里提自己的需求来触发。是的,看到这里你应该发现了,这个Workspace目前是无法直接在IDE里使用的。最近出了一个VsCode插件(2024.09.21 目前需要自己去下载vscode 插件文件安装),但是这个插件只能做到帮忙同步修改到vscode中。 先介绍下流程吧,同样是之前测试Cursor Composer的那个需求(它没能完成),我直接通过Github Issue触发的: https://github.com/xieisabug/tea/issues/2点击了之后就自动进行分析,会列出它对需求或者bug的分析和解决方案。分析和方案都可以手动增删改,而且可以点击上面那个聊天的窗口对代码的情况进行自然语言描述,Workspace会根据描述再次改进之后,生成分析和解决方案。确认好分析之后,会根据分析来生成实现代码的计划,按照文件来列出所有计划,这个计划也是能自己进行增删改的。再之后就直接确认开始修改代码了。 评价 工程能力部分 体验上来说比Composer要强上一些,毕竟编写代码是需要一定时间的,所以在我确认了你要如何修改之后,再去编写代码,我觉得这是能节省我大量时间的。 而且寻找需要修改的文件比Composer的能力要强很多,应该也是在代码搜索方面下了很多功夫的,这次测试中,能准确找到我的rust文件和前端文件,但是同样找不到我的测试文件,好在我可以轻松的在Plan里自己加上这个文件。 不过同样是写错的代码就直接错了,还是需要自己去调试的,好在有一个vscode插件能够同步修改到vscode里调试,之前没有这个插件的时候,只能在网页上人肉看,看完了提交然后再到vscode拉取到本地去修改。 代码完成部分 Copilot Workspace只能用默认的模型,也就是gpt 4o,之后可能会加上o1家族。 使用了gpt 4o可能要作为减分项了,gpt 4o写代码完全不如sonnet 3.5,并且会犯Copilot也犯的错误,比如下图: ![[Pasted image 20240922164323.png]] 喜欢去掉别人的括号或者分号,很是蛋疼。 UI UX部分 本来属于加分项,个人的体验感受是比Composer要强上不少的,直观、灵活,但是只能在网页上用而且只能用于Github项目,这应该就劝退了很多用户使用了。 希望之后Composer或者别的项目能够参考Workspace项目的界面交互。 总结 如果Openai未来的模型代码能力提升上来,或者把o1接入进来,未来比Composer可期。
- Xieisabug
- 23 Sep, 2024
工具-Cursor Composer
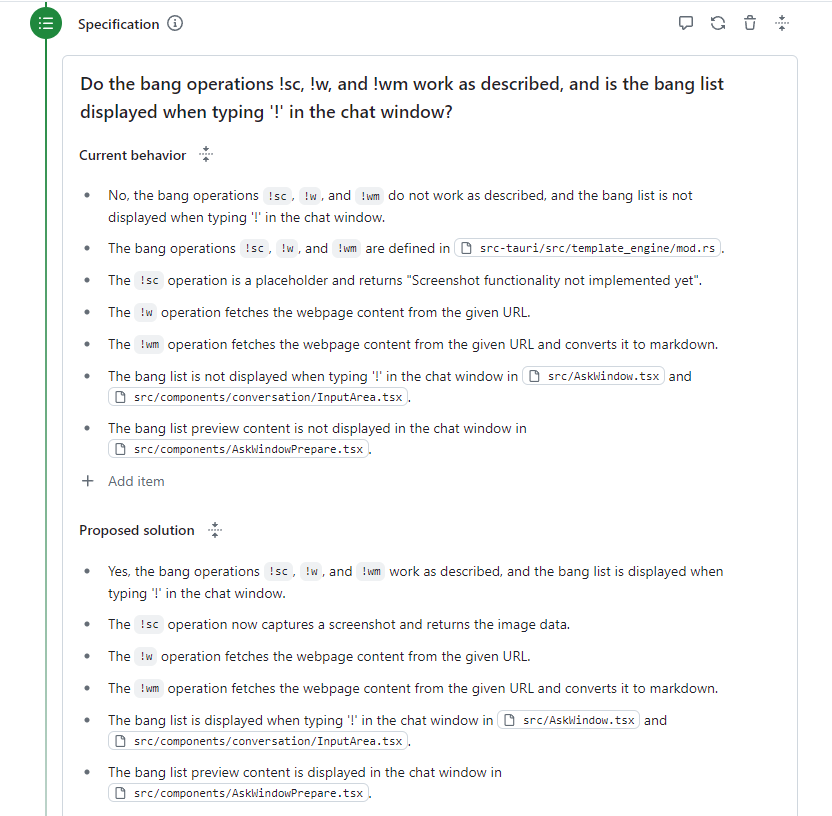
我在我的开源项目上正式使用了一下Cursor Composer,这是一个相对来说中型的客户端项目,用这个项目来做测试有两个目的:一是我不想测试从零开始搞个网站或者开发个小工具的场景,那在我的日常场景中占比太小了,没有参考价值;二是我的项目刚好还有很多需要做的新需求,这些需求足够清晰且难度大于单独写一个网页。 使用的需求场景是这个Issue:https://github.com/xieisabug/tea/issues/2 输入到Composer的Prompt就是Issue的描述: 当前的bang操作有: !s、!selected_text 获取打开快速聊天窗口之前选中的文字(暂时不太好用,需要优化) !sub_start([text],[length]) 从开始截取[text]文字[length]长度 !ct、!current_time 获取当前的时间 !cd、!current_date 获取当前的日期计划增加: !sc、!screen 获取打开快速聊天窗口之前的屏幕截图 !w([url])、!web([url]) 获取对应[url]的网页 !wm([url])、!web_to_markdown([url]) 获取对应[url]的网页并且转换为markdown在 快速聊天窗口 或者 完整聊天窗口的新对话界面 中展示部分bang的预览内容 在输入框中敲击!时出现bang列表用于选择评价 工程能力部分 能够在我仅给出需求的情况下,准确的找到了之前编写bang的rust代码文件,属于加分项。但它并没有对我的前端文件进行更改(rust和前端都在这一个项目里),因为我的描述其实明确提到了需要修改界面。 并且它没有帮我创建对应的测试用例来检测该bang的实现,我是有专门针对bang的测试文件的,如果能力强一点肯定是能发现需要编写测试用例的,不过在我要求创建测试用例的时候,它还是能准确的找到之前编写测试用例的文件并且完成测试用例编写。 代码完成部分 此次测试使用Sonnet3.5加持。 正确按照我之前的编写模式创建了我需要增加的6个bang命令,且实现了获取网页内容和获取网页内容并且转markdown这两个功能的内容。 但是,实现的部分功能不可用甚至报错,当然这不是Composer的问题,这是大模型的问题。但它没有将大模型出现的非前端问题解决掉,而是留在了那里。 UI UX部分 都说Composer交互是最好的,个人觉得还不是最完美的方案,对话界面和功能较为割裂,我觉得可能会有更好的展示方式来对每次对话产生的影响进行展示,比如每次修改产生的影响都和对话做一个能够对印上的交互。 并且不知道是不是我使用的bug,我过去使用的Composer记录找不到,个人觉得查看过去的Composer然后继续改还挺重要的。 不过能够直接在编辑器里选择每一项更改是否生效,这个交互还是比较爽,不过我想这个操作是否有必要,在不久的将来,肯定是无需人去干预这个交互的,而且如果有git之类的版本控制,基本的IDE都能看到修改对比的。不想修改这个不分直接撤回就行了。 总结 和我之前Cursor的评测结论差不多,干简单的事情太麻烦,干麻烦的事情干不成,未来可期。
- Xieisabug
- 21 Sep, 2024
大模型-用Deepseek翻译时带给我的欢乐时刻
文章全部是我在使用沉浸式翻译+deepseek的时候发现的欢乐时刻,翻译的全都很传神。 不香吗?我他妈高兴坏了啊对对对YYDS我们程序员就是这么说话的真是!以上均是使用沉浸式翻译自带的AI专家 Twitter翻译增强器:
- Xieisabug
- 28 Aug, 2024
工具-Cursor
很久以前,我曾使用过Cursor,当时它完全无法与Copilot相提并论。没想到现在再次使用,体验上的差距竟然如此巨大。 首先是"无限Tab"功能,虽然触发频率较低,但一旦触发,它所带来的感官冲击非常强烈,令人难以不被震撼。仅仅修改了一处地方,多个位置就出现了shadow text,然后一路tab全部应用,只需触发一次就能爱上这个功能。 其次是Chat功能,与之前使用的Zed AI类似,它能够方便地携带各种信息,包括上传的文档、网页、Git仓库、整个文件夹等等。虽然节约的只是复制和粘贴这两个操作,但这两个操作需要重复无数次。如果能够快捷地自动带上当前文件、选中的代码或整个代码库,那么解决的总操作量在高强度使用下每天可达数百甚至上千次。 最后是Composer功能,被大家广泛誉为Cursor杀手级能力。但实际使用下来,体验并不理想。通常简单的任务用不上Composer,而复杂的任务Composer又无法完全胜任。不过,显然这是一个前景可期的功能,随着大模型能力的提高,这个功能只会越来越好用。等到下次像Sonnet3升级到Sonnet 3.5这样的更新再次出现时,Cursor必然会更加强大。当然,类似的功能并非只有Cursor拥有,Aider也提供了相似的功能,是否还有更多类似工具我就没有深入了解了。 总而言之,作为VSCode上的一个"扩展",Cursor完全有能力替代VSCode。不过Cursor的价格是Copilot的两倍,我目前不会选择订阅。它的体验并没有比Copilot好一倍。像自动补全、Chat、Apply以及Codebase的自动上下文等功能,Copilot都做得很好。仅凭多次Tab和一个尚不完善的Composer功能,不值得我多花一倍的钱。
- Xieisabug
- 23 Aug, 2024
大模型-自动编写SecRule规则验证工具
背景 我们有类似waf的攻击检测产品,所以需要测试一些攻击是否能够正确识别,并且识别的原因是否正确,如果是自己去看规则,来编写,几十上百个规则太难了,要搞很久很久,而且是非常无聊的任务 大模型 用大模型来完成这个任务刚好,大模型懂SecRule语法,并且能够理解正则表达式,是干这个活的完美人选。 只要写一个不太烂的prompt约定一下产出的格式,我这里是产出的python代码,然后保存为文件,方便我以后经常调用验证产品。 import pandas as pd import openai import os# 设置OpenAI API密钥和自定义endpoint API_KEY = '' # 替换为您的自定义endpoint API_BASE = ''# 读取CSV文件 input_csv_path = 'input.csv' df = pd.read_csv(input_csv_path)# 创建一个数据目录 output_directory = 'payload_output/' os.makedirs(output_directory, exist_ok=True)# 假设CSV文件中有一列名为'text',我们将对其进行文本生成 generated_texts = []client = openai.OpenAI( api_key=API_KEY, base_url=API_BASE )for index, row in df.iterrows(): print(f"正在处理第 {index + 1} 行... {row.iloc[0]}") prompt = row.iloc[1] # 调用OpenAI的API生成文本 response = client.chat.completions.create( stream=False, model="deepseek-coder", # 选择适当的模型 messages=[ {"role": "system", "content": """ 需要对WAF规则进行匹配测试,所以要根据用户提供的Secrule规则进行python poc的编写。 请使用requests库来进行请求发送,函数名直接命名为attack,在函数的顶部用注释表明该模拟的意图,传入参数为url、cookie,url为模拟攻击网站host,cookie参数如果生成的poc脚本中用到了则拼接在一起,否则直接传递cookie参数,举例如下: ```python # 模拟cookie中超过3个符号 def attack(url, cookie): payload={} headers = { 'Host': 'example.com', 'Cookie': 'TestCookie=-1-1-1-1-;' + cookie, 'User-Agent': 'Jetknown-Test-Case' } response = requests.request("GET", url, headers=headers, data=payload) print(response.text) ``` 仅需输出代码块,不要进行解释和说明,也不要在代码块中引入requests """}, {"role": "user", "content": "规则如下:\n" + prompt + "\n"} ], max_tokens=4000 # 根据需要调整生成文本的长度 ) generated_text = response.choices[0].message.content.strip() print(f"生成的文本:{generated_text}") # 从生成的文件的markdown中提取代码 generated_text = generated_text.split("```python")[1].split("```")[0].strip() generated_text = "import requests \n\n" + generated_text # 将生成的文本保存到文件中 file_name = f"{output_directory}attack_{row.iloc[0]}.py" # 写入文件 with open(file_name, 'w') as f: f.write(generated_text)然后写一个代码来动态引入python文件并且执行 def execute_attacks(directory, url, cookie): # 遍历指定目录中的所有Python文件 for filename in os.listdir(directory): if filename.endswith('.py'): file_path = os.path.join(directory, filename) # 动态导入Python文件 spec = importlib.util.spec_from_file_location(filename[:-3], file_path) module = importlib.util.module_from_spec(spec) spec.loader.exec_module(module) # 检查是否存在attack函数 if hasattr(module, 'attack'): attack_func = getattr(module, 'attack') # 执行attack函数 try: result = attack_func(url, cookie) print(f"执行 {filename} 中的attack函数,结果: {result}") except Exception as e: print(f"执行 {filename} 中的attack函数时出错: {str(e)}") else: print(f"{filename} 中没有找到attack函数")大大减少手写测试用例的工作量,提高测试效率,而且可复用,方便后续持续验证产品。并且如果发现不理想的代码,可以挑出来再让大模型重新生成。

- Xieisabug
- 22 Aug, 2024
工具-Zed AI使用体验
编辑器 从IDE的角度来说,Zed还有很长的发展路径。在使用过程中,我发现作为一个IDE,它还缺失了很多功能,比如Git相关的操作(能展示状态)、数据库查看管理等。不过,如果将Zed作为一个轻量级的编辑器来替代Sublime,它绝对是完胜的。与Vscode相比,Zed确实快了很多很多,没有基于Electron构建这点就自带速度属性了。 作为一个普通编辑器,Zed该有的功能基本都具备。但是在配置方面,它比Vscode更原始,很多配置在Vscode中至少可以通过界面进行,而Zed的配置只能通过JSON文件来完成。 特色AI功能 就是冲着这个AI功能体验的Zed,核心思想是在对话界面把上下文都丢给AIAI回答之后在文件需要修改的地方直接让AI应用刚刚对话里的方案白送的Claude 本来这可以作为Zed的一个加分项,但实际体验下来,发现很容易触发rpm限制。一旦达到限制,Zed送的Claude就报错没法继续用了。不过还好,我们可以使用下面的方法来解决这个问题。 使用Copilot 没错,我们可以直接使用Copilot提供的4o作为聊天工具,它同样具有输入补全的能力。这样既不会浪费之前为Copilot付费的钱,还能获得不错的体验。 配置Deepseek Zed非常适合Deepseek,Zed AI的理念会使用大量的token(很多文件作为上下文),并且在AI应用到文件的时候,会把问答里的内容当做上下文全部带上,Deepseek刚好能够完美hit cache,但需要使用Cloudflare Worker把openai的model转成deepseek coder。以下是转发的示例代码(给个例子,这是我很多转发中的一个): export default { async fetch(request, env, ctx) { const url = new URL(request.url); let pathArray = url.pathname.split("/ds-beta"); if (pathArray.length <= 1) { return new Response('Bad request: Missing `redirectUrl` query param', { status: 400 }); } // 克隆原始请求 let originalRequest = request.clone(); // 读取并打印原始请求体 let originalBody = await originalRequest.json(); console.log("Original request body:", JSON.stringify(originalBody, null, 2)); // 修改 body let modifiedBody = { ...originalBody, model: "deepseek-coder" }; // 创建新的 headers, 复制所有原始 headers let newHeaders = new Headers(originalRequest.headers); // 更新 Content-Type header newHeaders.set('Content-Type', 'application/json'); // 创建新的请求,包含修改后的 body 和所有原始 headers let newRequest = new Request(originalRequest, { body: JSON.stringify(modifiedBody), headers: newHeaders, method: originalRequest.method, }); // 打印修改后的请求体 console.log("Modified request body:", JSON.stringify(modifiedBody, null, 2)); console.log("send request to deepseek"); // 使用修改后的请求发送子请求 let res = await fetch("https://api.deepseek.com/beta" + pathArray[1], newRequest); console.log("receive response from deepseek", res.statusText); return res; }, };感受 换用了一个简单的IDE后,在编写简单项目的时候,感觉更加专注了(可能这就是为什么那么多人喜欢使用Vim的原因吧)。它带来了一种编写代码的快感(??)。 Zed支持Vim模式、多光标编辑、代码跳转,可以使用Copilot,AI功能在某些情况下非常给力。通过JSON配置task后,使用起来非常便捷。它确实非常非常快,并且支持大多数常用的编程语言。 不过,Zed的Git管理需要通过命令行进行,没有直观的图形化配置界面,它的插件支持也非常有限。
- Xieisabug
- 22 Jun, 2024
大模型-MoA方法尝试
由开源大模型API提供机构Together提出,论文地址 这篇论文探讨了一种称为混合代理(Mixture-of-Agents, MoA) 的方法,旨在提升大型语言模型的能力。混合代理(Mixture-of-Agents, MoA) 方法的核心思想是利用多个代理之间的协作现象来提升大型语言模型的能力。这些代理通过协作和信息共享,能够更有效地处理复杂的任务和提高模型的整体性能。 MoA方法在自然语言理解和生成任务中表现出色,尤其是在推理任务(如MATH数据集)中显著提高了模型的准确性和效率。通过这种协作机制,MoA方法能够充分发挥每个代理的优势,从而提升整体模型的能力。 从代码不难看出,实际上该方法就是定义了很多个不同的大模型: default_reference_models = [ "Qwen/Qwen2-72B-Instruct", "Qwen/Qwen1.5-72B-Chat", "mistralai/Mixtral-8x22B-Instruct-v0.1", "databricks/dbrx-instruct", ]然后对于用户的输入问题,使用上述定义的所有大模型进行回答: with console.status("[bold green]Querying all the models...") as status: for i_round in range(rounds): eval_set = eval_set.map( partial( process_fn, temperature=temperature, max_tokens=max_tokens, ), batched=False, num_proc=num_proc, ) references = [item["output"] for item in eval_set] data["references"] = references eval_set = datasets.Dataset.from_dict(data)其中的process_fn就是用模型进行回答。将所有模型的回答统计到一起之后,再使用一个模型来进行总结: output = generate_with_references( model=model, temperature=temperature, max_tokens=max_tokens, messages=data["instruction"][0], references=references, generate_fn=generate_together_stream, )这就完成了所谓的MoA,这其实和我改造的MetaGPT的使用方法一样,但是MetaGPT的方法有一个更好的点在于每个Agent都是经过精心编写的提示词,而这个MoA并没有,而且MetaGPT为每个Agent选择最合适的大模型之后,和这个所谓的MoA其实没什么区别。 Together是想通过多个臭皮匠来顶一个诸葛亮,但是达到的效果是多个臭皮匠顶不了诸葛亮,只能达到多个臭皮匠中最强的那个臭皮匠的能力,再多的臭皮匠得出的结论99%也是臭皮匠的结论,只不过是5条臭皮匠的结论变成了10条。我测试的3.5Sonnet和GPT 4o回答的效果都是特别好的,几乎趋近甚至超越我。在大模型中,最重要的还是模型本身,其次是提示词,再次才是工程化,想通过工程化来提高模型回复的能力,这条路走的注定比前面两条路要更难。
- Xieisabug
- 25 May, 2024
大模型工具-Shell Helper
https://github.com/xieisabug/shell-helper 根据原repo汉化并稍加修改而来:https://github.com/76616c6172/shell-helper 替换了原来调用的openai gpt4o,用了更加经济的yi-large-turbo,用来提示shell脚本是完全没问题了,但是再向下调整,给出来的命令几乎就不可用了。 主要思路就是让大模型根据需求,给出带有shell脚本的代码块,然后用python代码去匹配markdown代码块然后根据用户的输入来使用python进行运行或者复制。 技术上没啥好分享的,重要的是这个使用大模型的思路,平时的一些比较琐碎的烦恼都能够将一部分丢给LLM来解决。