Showing Posts From
Ai
GrokBot使用感受
体感 我一共有两个GrokBot账号,一个是老Cursor 60刀里带的,一个是新Unify 30刀套餐的,这个新套餐的30刀是真不够用,后续我会升级成100刀(我想吐槽一下它这个首月优惠。我开的时候是15刀,也就是半价,但我想升级到100刀的时候,就不能按照50刀的半价来升级了,我要补85刀,劝退,下个月再升吧)。 先说一下使用的前提,必须开TUN模式,让流量全部都走代理,代理需要美国的,能家宽是最好的。只有这种情况下GrokBot才会使用Opus 5.5,否则会使用Grok 4.5,两者体感相差巨大(谦虚的说法,实际上Grok4.5我就建议别用了,只会帮倒忙)。可以用 https://lm.ikale.io/ 来进行指纹检测,大概也就1分钟就能知道你用的什么模型了。 目前来说,我对GrokBot的好感还挺高的。我觉得它的优势首先是每一个请求都会给你使用最好的模型,也就是Opus 5.5,我觉得它的体验比Dot和Muse好的原因,也就是在这了,因为这种多Agent协作的模式,Agent如果不够聪明,不够能够互相理解,那这个产品是不能成立的;第二个优势就是它什么都给你做好了,它拥有电脑,它无需配置开箱即用且拥有最强的模型和几乎需要用到的所有工具,比过去的助手要强太多了,什么你都不需要操心,只管用就行了(这才是真面向用户的产品核心)。 使用 我目前在GrokBot里面有几个独立Agent和三支完整团队,分别维护三个不同的项目,一共二十几个Agent,使用起来负担非常的小(所以如果额度管够,我应该可以维护十个不同的项目,因为过去我就是十几个Agent开着用的)。和我之前用Herdr等同类产品的体验相差太多,现在用起来需要看的信息非常的少,可以看的出他们为这个做了不少的努力,大部分的模型输出全部都被隐藏起来了,又因为它使用的是最强的模型,所以你也没有任何心智负担担心这个模型乱搞,根本就不会乱来的情况,我目前派发的所有任务完成的都非常的完美。 举一个我现在开发游戏的团队例子:我通常先和总管交互,总管负责所有的项目管理,所以我的这个游戏项目也可以直接只和总管交互。但我有时候也会和运筹交互,也就是这个项目的产品经理。这个产品经理会把我的意图解析,分解成不同的需求,然后放到我的需求平台上,并派发给程序或者美术来实现(程序就是墨斗,美术是丹青),再之后程序或者美术实现完成,会由运筹和朱批(也就是测试)来进行测试和review验收。其中朱批它是直接使用自带的电脑来进行实操测试的,也就是把游戏会运行起来玩一遍。他们会互相的沟通,来分派任务和推进进度。杂物助理会承担一些研究的工作。 其他的团队也类似,但他们的角色可能更多,比如说程序员可能会有很多,测试也可能会有很多,他们能够并发的进行需求的处理。然后还有一些运维相关的工作,会有一些别的Agent来做。 当然,问题也是有的,之前ctrl键无限抽风,而且现在也不能够改快捷键只能看,windows上经常有闪屏白屏的问题(感觉应该是electron的锅,因为vscode也有同款毛病),但瑕不掩瑜,产品整体我觉得站在巨人的肩膀上又站了一个小巨人的感觉吧。 总结 (叠甲:我用了GrokBot、Dot、Openclaw、Hermes、Workbuddy 等各种助手应用,还包括我自己写的AIPP,所以不是没有比较的乱夸) 后续我会改改AIPP,目前AIPP已经有类似的设计了,也就是它有一个总管家,能够把所有的活分派给各种助手来进行任务。但是目前的交互达不到grok bot这样好,也没有像grok bot这样把一些细节隐藏起来,而且也没有电脑控制的能力。之后我会让AIPP能够远程控制另外一台电脑来达到类似的能力。 我觉得Cursor团队的理念非常牛逼。在上一个AI发展周期中,也是Cursor团队提前做出了类似的概念,然后等到了模型的能力更新。我觉得这是一个真正做产品需要的能力,也就是有远见,挺佩服的,他们的成功绝不是偶然。

How I AI Coding in 2026.10
打开了去年的 How I AI Coding 2025.10 ,感觉恍如隔世啊,真实AI一日地上一年,看看今年有啥变化了。 工具 herdr, Paseo, Codex, Claude Code, Kimi Code, pi, AIPP, Cursor 现在用的比较多的是 Codex cli 和 pi,一般有大点的需求我就用Codex来跑,小改动就pi+deepseek flash来改,Kimi Code是之前定了Kimi的时候用的,发现也挺好用,现在改在咸鱼买Kimi了(咸鱼牛逼)所以就也保留了继续使用Kimi Code(kimi专武);最近Opus 5.5牛逼起来了,所以很久很久没用的Claude Code我也翻出来了,专门跑Opus 5.5(我就是这么喜欢专武)。 这些cli我都是跑在herdr里,能把我的工作区很完整的保存起来,这也是为什么我用那么多CLI工具的原因,我把。相比GUI来说,herdr我通常会开8-16个agent跑并且一点都不卡,非常舒服。(用的时候记得用语音输入,输入效率和prompt的准确率会提高一个数量级)Paseo只有一个情况我会开,那就是我要出门了,这时候开一个Paseo我的手机就能用电脑继续跑agent工作(AIPP马上也要加上这个功能了,这功能我是真喜欢)。 AIPP是我处理日常事情的主力(最近用了下GrokBot,发现agent有个电脑是很重要的,所以AIPP之后也会跟进一下),我至今没有发现有一个客户端能够让我完全满意的,所以AIPP还是必要的,等到我找到这样一个完美的开源的客户端的时候,我也许就会放弃AIPP的开发了。 还在用Cursor这种古玩,我估计很多人会觉得惊讶,但我始终认为如果要把一个产品做到一点不将就那肯定还是需要手改很多东西(目前),比如我现在的游戏的每一句台词我都会自己改一遍,AI的文笔和节奏和“玩梗”能力和人都差的太远,用agent来一个个改真不如我Cursor几分钟搞定。 订阅 中转站Codex和Claude,咸鱼kimi,Lenny's Product Pass, cursor pro, kagi 我没有买官方的codex订阅,因为中转站的codex已经足够便宜了,而我又没有在web chat的需求,我的chat全部都由AIPP承担了,如果我的用量足够高的情况下我应该还是会订一个Codex订阅,但目前来说还没有哪个月会超过200刀。而且我还不用担心降智的问题,这方面的问题由中转站去解决。 我以前定的都是官方的kimi,我觉得还挺好用的,直到我的同事告诉我咸鱼上有卖kimi中转的,按次收费,29.9能够用10w次。我测试了一下,确实是kimi k3,并且29.9就已经能够满足我高强度使用了,况且我还有别的模型。(咸鱼上真是啥都能买到啊) Lenny's Product Pass 我其实感觉真的很划算,我用了里面的 Cursor Pro年卡+Warp年卡 就已经值回原来的价格了,还有各种其他的订阅比如 Runway、Gamma 之类的,对我来说真的超值,最近还领了一个Cursor Pro+(就是通过这个试用的Grok Bot,不过好像已经领完了,Cursor的一年订阅好像也没了),我还有很多没领的订阅之后可以尝试尝试(咸鱼上也有人把Lenny's拆开来卖的,会比原订阅要便宜很多)。在我第一次使用Kagi之后我就一直没有退过了,期间各种情况下也用了百度谷歌之类的搜索,只能说无法做到消费降级了。 改变 相比去年,今年在AI上的花费要变多了不少,很多大手大脚使用AI的情况还是源于公司能够报销一部分,但最近公司解散了,报销也没了,不过我还是决定留下这些AI,刚好利用闲下来的这段时间,再加上AI的突飞猛进把想做的几个东西好好打磨毕业。 但是我感觉我通过使用这些AI能力确实也强了很多,不光是AI的能力让我做到更强,我自己也更强了 ,我能够在2-4个项目之间快速切换,十几个agent的对话框游刃有余的布置任务和审阅结果。以前总想做个10x程序员,现在我觉得我能当得上100x程序员了。
How I AI Coding 2025.10
因为看到了Xuanwo大佬的文章,所以我也来写一下我是怎么用AI来开发的。 工具 VSCode Insider with Copilot,Codex,Claude Code,Kagi,AIPP 现在日常用的就是VSCode Insider,因为Copilot的新特性基本都是先在Insider版本试用的,所以如果要用到最好的Copilot就只能牺牲一点稳定性来使用Insider版本了。目前我的工作里有很大的部分是无法通过Vibe Coding来完成的,所以还是比较依赖编辑器里的代码补全,Copilot现在是用的GPT 4.1 来做的代码补全模型,智力和速度都是在线的,也有Next Edit Suggestions,很符合我的需求。Copilot Agent现在比过去的可用性提高了很多,比以前更能利用模型的能力,也加入了Todo、PlanMode 之类的辅助能力,也很少出现只读文件一部分的情况了,Apply的速度虽然说比不上Cursor,不过也算快了。而且Copilot订阅有网页端,在 https://github.com/copilot ,日常有一些问题可以在网页端直接询问,不需要别扭的在 VSCode 里来询问和代码不相干的事情了,我通常有一些常识性的问题或者对Github上仓库的问题都会在网页端用Gemini 2.5 Pro来进行问答。Copilot网页端的Agents在我的测试看来基本不可用,模型不明但是估计是Sonnet 4.5之类的,效果奇差,不过会启动环境做验证,期待未来吧。(还有个很重要的点就是我穷,Cursor现在的计费我要是放开了用会破产,Copilot高级请求用完之后,还有无限的4o和4.1使用,这点让我很安心) 然后就是Codex和Claude Code了,在Vibe一些小项目时Claude Code挺好,但是当项目大到一定程度或者问题达到一定难度后,Claude Code基本上就是帮倒忙了,这个时候GPT 5 High的智商优势就体现出来了,虽然一个任务大概率要跑十几到几十分钟,但是实实在在的能优雅的完成任务,所以我已经很少使用Claude Code了,基本换到了Codex。(我没有订阅这俩的官方服务,我是通过中转站来使用的,所以我只在需要使用的时候才会对这俩工具付费,这能节约很多钱。) 还有一个我觉得非常好用的工具就是Kagi(AI能力是需要付费的),搜索的非常精准,基本第一页就会出现我要的结果(保守的说法,其实一般第一条就是),在搜索引擎的能力加持下,它家的搜索Agent Ki就更强了,目前看只有GPT5 Pro的Search能够打打。Kagi在我做预研或者查解决方案的过程里,给了非常多的帮助。 AIPP是我自己写的开源ChatApp,别的ChatApp各有优势但也总有槽点,所以做一个符合自己使用习惯的,我在中转和国内的厂商(Kimi、GLM、Deepseek)都有充值,用API来对一些问题提问。现在也只是刚把功能做好,还有很多Bug,不过我自己足够熟悉更新迭代的也会很快。 MCP Context7,Jina,自己写的禅道、数据库MCP Xuanwo大佬在9月的版本中认为“MCP is still a lie”,我倒是有不同的意见,MCP在简化上下文资源中有命令行和基础工具不可替代的作用。 Context7是一个用于查询文档的MCP,是我必备的MCP,大模型的知识跟不上导致API经常使用过时,甚至新的库直接就不知道怎么用,不使用Context7就得自己去查了然后告诉大模型或者模型就开始胡说。 Jina是我用来让AIPP搜索和联网的MCP,也有很多别的替代不过我最偏爱Jina这家公司。 禅道MCP是我在AIPP或者Copilot中能够快速的查看Bug情况,数据库MCP则是连接公司内部的开发库来快速的开发和改Bug,如果不使用MCP很难有更高效的方式让我放心的对禅道和数据库进行授权让AI调用。 感想 Xuanwo大佬提的感想大部分我都赞同,我说一些我自己的别的感想: 多模态能力其实对写代码挺重要的,尤其是前端,目前感觉最好的是Gemini 2.5 Pro,因为可以接受视频的输入,连动效都可以实现。 绝大部分人的绝大部分编程任务其实不需要模型多高的智力,只要能够描述清楚,Sonnet 4.5或者GPT5 Medium就足够了,国内的GML4.6、Kimi K2也是足够的。 模型的智力比承载工具重要多了,参考Cursor和Codex就明白,Sonnet的进步让Cursor异军突起,GPT5 High的能力让难用的Codex也能忍着用下去。 AI产品需要反复的去用,很多东西刚开始用的时候非常垃圾,但是随着产品和模型的演进,突然就非常好用了。 所有的产品都可以用AI来重写一次,但是产品里的基础能力还是不可或缺的,AI也只能是替代原有产品的使用者来自动调用这些基础能力,没法替代产品本身。
 Xieisabug
- 17 Jun, 2025
日常-阅读 How we built our multi-agent research system
今天抽空阅读了 Anthropic 的 How we built our multi-agent research system,其中有不少过去就已经了解熟知的知识,也提到了不少能够激发我思考的点,来总结总结。 首先先说说之前就了解的:一个非常聪明的规划者。Anthropic 用的自然是 Opus,规划任务、决策都是 Opus 来做的,越聪明的 AI 做规划者越能提高执行者的效率和效果,目前第一梯队的规划者只有 3 个,Anthropic 4-Opus、OpenAI O3、Gemini-2.5-Pro,排名有先后。执行者的能力不能太低。Anthropic 的执行者使用的是 Sonnet,而不是 Haiku,执行者要能正确的使用工具,正确的遵循格式来输出,并且最重要的是能够理解任务的要点。使用记忆。PreAct 的要点就是提前计划并且生成 TODO,需要记住 TODO 完成的状态;在每轮迭代任务的过程中,都会产生新的结果,都需要进行记录;长时间执行的任务,会产生巨长无比的上下文,通常经过总结后也需要保存到记忆中。文章中配了两张图都提到了 Memory 可以看出它的重要。 之所以不把记忆归类到工具,是因为记忆可以算作一个基础设施,是必须要使用的,而工具是根据任务的不同可以选择用或者不用。使用工具。给予丰富的工具才能让 Agent 的智能发挥作用,最近看的最典型的例子就是,ChatGPT 网页上的 O3 在工具加持下能够通过非常普通的照片定位到照片拍摄位置。过去我倾向于看模型的 Aider 评分来看模型的能力,因为这个评测集通常反应了模型编写代码和指令遵循的能力,但发展到现在的阶段,Aider 的评分已经无法反应出模型真正解决问题的能力,现在我更喜欢看模型的 SWE-bench Verified 评分,这是一个经过筛选的现实问题集,考验模型使用各种工具来解决现实问题的能力,不过通常强的模型这两者的分数都不会低。再来谈谈新的收获:巨量的 Token 消耗。Anthropic 提到 Multi Agent 是普通聊天的 15 倍 Token 消耗,所以应该让 Multi Agent 作用在能产生高价值的地方,而不是普通的任务。我之前有想过为什么 AI IDE 不搞一个这种 Multi Agent 模式,能够又聪明又快速的完成任务,从这篇文章中可以一窥原因,现在的 AI IDE 不约而同的让自己的工具在尽量少的 Token 消耗的情况下来解决问题,但基本都是事与愿违,有时候看着 AI 50 行 50 行代码的 read,真的哭笑不得。想必这就是 AI 提供商巨头的护城河,他们的 Token 基本上是 Free 的,通过烧 Token 来提高效果这是一般的应用公司没法做到的。Agent 调试。之前从没有想过来做一个工具像断点代码一样调试 Agent,Anthropic 做了一个工具,能够逐步的观看 Agent 如何进行处理,这使得在 Agent 优化的过程中能够直观的、不停的 减少 不必要的工具调用、生成冗长的搜索词等。这也让我想到了可以把 传统编程中的很多调试方法都带到 AI 应用开发,除了断点,还有像日志(做个 MCP 来让 AI 自动输出日志到指定的地方)、Mock(假设模型的前置返回或者 MCP 的返回来进行测试调试)等等,对于 AI 这种黑盒开发有不小的帮助。智能体自我进化。像 Cursor 中的 Agent 自动调用测试获取报错信息或者是获取 Lint 报错一样,如果任务执行的不好,Anthropic 会让 Sonnet 自己来修改提示词再次进行尝试,直到获取到更好的结果。甚至当提供的 MCP 工具有问题时,Sonnet 会去修复这个工具然后继续。之前看信息流里有 OpenAI 的老哥说 O3 的降价也来自于 Codex 对系统的自我进化开发。这相当于强化学习训练出来的 AI 来用强化学习的方法来训练一个应用?并行处理。不光是把任务分解后多个 Agent 同时去完成所有的任务,还有 Agent 同时调用多个工具来解决一个任务。这个想法其实我之前也想到了,并且在一个 Side Project 中也实践过了,效果非常好,这个 Project 是一个小说编辑器,在对小说进行润色的过程中,会让规划者先标记出来哪些句子需要润色,再让多个执行者并行的对每个句子来进行润色。原来这个任务在润色一篇 3000 字的文章时,起码要等待 40 秒(使用的是 gemini 2.5 pro),使用了这种方式之后,大约 10 秒内就能看到结果了。提示词优化。Anthropic 提到一个微小的提示词修改,使得任务成功率从 30% 提高到 80%,这让我想到之前听的播客中的一个观念:如果我修改16 次提示词最终完成了比较难的问题,那么这个过程中,到底是我太菜了还是 AI 太菜了?Anthropic 很大方的开源了自己的提示词,可以去 Anthropic 的仓库里看看。工程化。Anthropic 提到了很多工程化的问题,包含了 恢复状态、容错、可调试可观测可测试、部署更新、执行与并发 等各种挑战,这也是每个做 AI 应用的开发者都可能会碰到的问题,所以 AI 应用并不是写个提示词那么简单,涉及到的编码和传统软件工程的知识都非常多。在目前,至少是 2025 年 6 月这个节点,根本不可能有真的0编程知识的人能够使用 AI 开发上线运营一个应用。想法: 我曾经花了一个小时,和 AI 对谈让它来不停的问我问题了解我,最终总结出了一大篇关于模仿我的提示词,然后我就可以与“我”对话了。不过这个“我”的上下文还是太少,比如我正在写的项目和完成的进度,比如我的朋友同事们的性格和我们之间的经历,比如我还有一些并不符合 AI 政策的想法无法输入进去。同时“我”的能力还是太少了,抛开能影响现实中的能力不谈,在电脑中的能力也少的可怜,虽然我也配置了很多 MCP 但 AI 任然不能用我的电脑做任何事,比如聊微信、写 Word、刷信息流等等。但如果我提供了某个特殊领域的所有工具,比如程序员或者产品经理,它能够写代码、执行命令、获取错误、截图看效果、写 Markdown 文件、发飞书通知、查看禅道 Bug 情况、跟进飞书多维表格的任务进度,那他是不是真的可以成为某个领域中的我,然后再用 Multi Agent 技术来模拟许多个我,让我的效率得到千百倍的提高。这件事我会去做,不过估计做的会比较慢,我相信随着模型智力的提高,最终的那个“我”肯定比现在的我要更胜任我的工作,那时候我应该可以躺着了。 最近一直被安利 Claude Code,不过没抽时间去试,昨天偶然看到了一个 MiniJinja 的作者使用 Claude Code 修复现实中的 Issues 的视频,可以看到的是,Claude Code 并不能真正“完美”的完成任务,改动的方案并不是最佳的,也没有遵循用户的指令先进行方案讨论不要立马实现代码,修复这两个 Issue 都是需要资深开发者来介入的。所以我一直偏向 Cursor 这类 AI IDE,纯 Agent 很容易把原来优雅的代码改成屎山,然后又要花时间去把屎山做优雅。不过如果是 Vibe 一个简单的 Side Project 用这种方式应该还是很舒服的,等我下一个 Side Project 启动的时候我会开一个 100 刀的 Claude Code 试试。
- Xieisabug
- 05 Mar, 2025
日常-AI 帮我解决了Cloudflare Worker 和阿里云 SDK 的小坑
最近有个小玩具要做,想要能够通过授权链接来给公司的阿里云服务器添加白名单。最开始想到这个事情的时候,就决定用 Cloudflare 的 Worker 或者 Pages 来做,因为开发方便,又不需要自己搞服务器来部署服务端和数据库。也因此踩了个小坑,特此记录。 首先我选择了 Pages,因为可以加前端页面,前后端都写到一个项目里,反正是个小玩具。前端不赘述了,用 Cursor 直接简单描述一下就能生成,包含登录页和功能页两个页面,用 Pages 提供的 Function 能力直接进行 JWT 鉴权,开发得飞快。然后核心功能点就是功能页里的授权白名单按钮了。 这个功能从 Cloudflare 的 Request 中拿到访问的 IP,然后和 D1 数据库里用户上次授权的 IP 进行比较,如果相同则不去阿里云授权,如果不相同,则删除用户上次授权的 IP,然后再添加新的。此时我去阿里云的开发者网站上找 OpenAPI,只看到了几个 SDK 的使用示例,而且做得还挺不错的。于是挑选了一个 Node.js 的 SDK 然后开发这个功能,开发也异常顺利,我直接上传到 Cloudflare 进行测试,突然看到报错: [unenv] https.request is not implemented yet!我是知道 Worker 是一个不完整的 Node.js 环境的,但是没想到这个包也没有,关键是阿里云的 SDK 没有提供修改“网络请求实现”的方法,我也没在阿里云的开发者网站上发现直接的 RESTful 调用方法。 当我一筹莫展的时候,我发现阿里云的官网上有个 AI 功能,就是这个按钮:没抱啥希望地点开问了问,居然真的给我找到了 RESTful 接口的调用方式,并且还让它直接生成了可用的代码:我把使用 fetch 的代码丢给 Copilot,然后让 Copilot 参考一下,把之前使用 SDK 的代码换成新的使用 fetch 的,直接一把搞定。 总结起来两个坑:阿里云其实是有 RESTful 的调用方式的,不过官方示例工具里只提供了 SDK 的示例,通过 AI 能够查到,估计是隐藏得比较深吧。Worker 环境里很多 Node.js 包不可用,都需要使用 Worker 专用的包,GitHub 有很多,不过Worker现在支持的Node 包也越来越多了。本该俩小时搞定的东西,最后搞了一天。
- Xieisabug
- 01 Sep, 2024
VS Code Copilot、Zed AI、Cursor 对比
背景 我决定评测这三个产品的原因是,我日常都是使用的VS Code Copilot,很久以前尝试过Cursor感觉不理想,但是最近国外都很推崇Cursor,就有点想尝试一下,恰好之前一直关注的Zed也推出了自己的AI功能,所以干脆集中一起使用对比下。 选手简介VS Code Copilot:算是“老牌”编程助手了,虽然Copilot在别的编辑器上也有扩展,不过体验最好的还是VS Code,毕竟都是微软家的所以功能集成更好一些;主要提供的是Complete和Chat能力,也就是代码补全和聊天。Zed AI:Atom的作者开的新坑,还是一个非常年轻的编辑器,以快著称;原本不提供AI能力,后来支持了Copilot(对,就是Github Copolit),近几天出的Zed AI支持Chat。Cursor:基于VS Code的开源代码来进行的二次开发,没有像Copilot一样作为VS Code的插件来编写,据作者说这是为了实现 VS Code 现有架构无法实现的理想交互方式;提供了Cursor Tab(原Cursor++)和Chat,其实也是代码补全和聊天,还有个“杀手锏”功能Composer。对比维度 我会针对下面几个维度,分享我自己的使用体验:IDE本身AI价格潜力详细对比 IDE本身VS Code:非常丰富的插件,插件多到可以直接配置出一个强大的IDE,但这样也就会拖慢VS Code的速度;最初使用VS Code是因为有些项目不是很重,使用的Go、Python、Nodejs等,开一个JB家的IDE犯不着,并且我很喜欢VS Code的Remote dev container,在我的M芯片上简直救我的命(很多库没arm版本);由于免费且用户数量巨大,所以社区异常活跃,我还没有碰到找不到解决方案的情况。Zed:刚打开这个IDE应该会懵逼一会,界面非常简单,简单的和Sublime一样,基本没有个IDE的样子,只能算作Editor,和使用下来的体验和第一印象基本一致,缺少了很多开发过程需要的功能,不过对于习惯使用Sublime或者Vim的用户来说,可能会习惯的比较快,我已经将一个Side Project的主力IDE切换为了Zed;快一直是Zed宣传的强项,我当时嘲笑了它,我为啥会需要120fps的切换tab?不过我还是被打脸了,用起来会发现它是真快,而且“快”对写代码是真的有加持(?我也说不清是为什么)。Cursor:由于Cursor依托于VS Code,基本和VS Code的情况一模一样,相对于Zed,它能支持VS Code的庞大插件群。**完善程度:Cursor > VS Code > Zed **使用感受:每个产品都有其独特的优势,但需要注意的是,Zed目前没有推出Windows版本。 AI 首先介绍大家相同的能力,基本都会提供代码补全和Chat的能力。 代码补全 其中Zed是借助的Copilot提供的代码补全,但要说一句的是它的代码补全比VS Code要快;而Cursor的代码补全体验是最好的,不仅快,而且时常会出现连续补全的情况,这个时候你只要不停地按Tab键,AI会猜测你后边的代码编写和修改,一并提示补全,值得注意的是“修改”代码补全是Cursor才有的能力,只要Cursor触发这个连续Tab,没有人会不喜欢Cursor了。 Cursor > Zed > Copilot Chat 三个软件都具有与当前代码上下文聊天的能力,其中Copilot和Cursor都对代码有embedding,可以自动调取上下文,Zed AI我目前没有看到有自动调取上下文的功能,上下文自动调取效果最好的我感觉是Copilot,能够非常精准的定位到我提问相关的代码,并且Copilot和Cursor都具有Apply的能力,也就是在Chat中的代码块能够自动以diff的方式映射到代码中,而Zed需要使用目前还在Beta的Workflow才能够触发Apply,普通的代码块无法直接Apply,但Zed有一个特别的能力,那就是Chat的内容允许随意修改,这个能力要结合Zed的别的能力来用,效果会非常好。 不分胜负 Inline Assitant 也是三个软件都有的能力,Cursor和Copilot的体验差不多,但Zed AI是在这个能力上发力了的,他的Inline Assistant是会带上Chat中的上下文的,这也是Zed AI演示的能力,可以在Chat中与AI进行多轮沟通之后,在工作区用Inline Assistant进行"应用代码修改",AI会再对应的位置根据之前聊天约定的内容来进行diff模式的代码修改,这期间肯定会携带大量的上下文,Token消耗非常巨大,解决办法就是使用带Cache的AI,比如Deepseek和Claude Sonnet3.5,我强烈建议大家配置个Deepseek,这样就算没触发缓存(第一次肯定无法触发)也不会产生太多的费用(Deepseek充个20人民币能用非常久了),还有一个解决办法就是上面说的编辑Chat内容,把多轮调整的一部分内容删去,或者手动添加一部分外界的内容进来用于Inline Assistant。 Zed AI > Copilot > Cursor 不同点VS Code Copilot:与VS Code进行了深度集成,在Source Control的提交框里都能自动帮你总结代码修改的commit message,并且最近更新了4o之后,Chat飞快。并且Copilot不光是可以在VS Code里用,比如写Java的兄弟们要用IDEA也是可以用Copilot的。Zed AI:Zed AI的理念和另外两个软件都不太一样,所以对比起来很不一样,但是就Workflow这样的能力来看,Zed的上限太高了,而且Chat里面的Slash能力是可以自己扩展的,比如官网示例就编写了一个Perplexity的插件,能够自动通过 /perplexity 来进行搜索并且把内容贴在Chat里当做上下文。Cursor:提供了一个叫Composer的能力。这个能力被很多人称为杀手锏,也就是对整个项目提需求,然后AI会自动对多个文件进行编辑,我使用下来除了很简单的需求,复杂点的需求或者项目,AI完成的都不是很好,但是很简单的需求其实也能直接在Chat里完成了。不过这个能力肯定是随着AI模型的能力而水涨船高的,未来可期。但是Composer的能力其实可以用Aider进行替代。价格VS Code Copilot:Copilot的订阅价格为每月10美元,我目前是用学生包获取了这个的,而且始皇还有override可以替换为自己的模型。Zed AI:目前Zed AI的价格策略尚未明确,但其基础功能是免费的,并且所有的功能都没有限制使用内置AI才能完成,可以自己配置API Key,就算以后收费了也没关系。而且目前免费试用期间,可以白嫖Sonnet 3.5,但是有RPM或者TPM的限制。Cursor:Cursor目前是20美元开Pro,免费只能补全2000次,很快就用完了。Pro包含了无限补全和500次高级模型的调用。最重要的是,Cursor的高级功能比如Apply、Composer等都是需要使用Cursor自己的模型才能够使用的。Zed AI > Copilot > Cursor 潜力VS Code Copilot:作为3位选手中,当前市场最好的编辑器,Copilot只要把自己的体验向Cursor无限靠拢,凭借低价格和多IDE使用,加之没有太多的限制,肯定是能够继续稳坐老大的位置的,至于非常新颖的交互方式,Github也一直在探索,最近出的Copilot Workspace就是其中之一,能够直接在Github的仓库里让AI来完成任务。Zed AI:单论潜力大小,那Zed肯定是进步空间最大的,光是向VS Code看齐就还需要很久了。不过AI方面独特的理念和高扩展性,并且也将大模型Cache利用的很好,用长上下文和大量的Token换取模型的编码准确性和全面性的提升,在我这至少是走的通的。Cursor:Cursor的潜力在于其独特的用户交互设计和Composer功能。Cursor Tab独一档的补全体验和Composer站在大模型智力的肩膀上只会越来越强,而且还有Shadow Workspace这种新颖的点子,以后也是能力非凡的。Cursor > Zed AI > Copilot 优缺点总结VS Code Copilot:优点:功能强大,插件丰富,AI能力出色,社区活跃,多IDE支持,价格相对合理。缺点:插件过多可能影响性能,部分高级功能需要付费。Zed AI:优点:界面简洁,运行速度快,AI理念独特,高扩展性,支持大模型Cache,价格策略灵活。缺点:功能相对较少,部分功能仍在测试阶段,暂无Windows版本。Cursor:优点:独特的用户交互设计,出色的代码补全体验,Composer功能潜力大,支持VS Code插件。缺点:价格较高,高级功能需使用Cursor自有模型,部分复杂需求处理能力有限。总结与建议追求功能全面和成熟稳定的体验,选择 VS Code Copilot。追求简洁快速的开发环境和高扩展性,选择 Zed AI。追求独特交互体验和尝鲜,项目复杂度不高并且不差钱,选择 Cursor。我个人会继续嫖Cursor的试用,然后有些项目会使用Zed AI来进行开发,并且配合Aider这样的项目来补齐Zed AI所缺失的Cursor Composer能力,在Cursor不能试用Pro后我应该也不会续费,目前来说这样的体验不足以让我多花10刀去为了这个补全付费,多出来的10刀购买API后可以在Zed AI和Aider用很久了。 能力/特性VS Code CopilotZed AICursorIDE完善程度最高基础高IDE性能可能因插件过多而变慢最快类似VS Code代码补全良好优秀(借助Copilot,速度快)最佳(快速,连续补全,支持代码修改)Chat优秀(精准上下文定位)良好(可编辑聊天内容)优秀(自动调取上下文)Inline Assistant良好最佳(带上Chat上下文)良好代码应用(Apply)支持需使用Beta版Workflow支持特色功能深度集成VS Code,多IDE支持Workflow,可扩展Slash命令Composer(多文件编辑)插件支持丰富有限支持VS Code插件价格**$10/月未定价,基础功能免费,可自配置API$20/月(Pro版)使用限制较少免费期有RPM/TPM限制免费版补全次数有限潜力稳定发展进步空间大创新交互,依赖模型进步**AI总结的表格
- Xieisabug
- 28 Aug, 2024
工具-Cursor
很久以前,我曾使用过Cursor,当时它完全无法与Copilot相提并论。没想到现在再次使用,体验上的差距竟然如此巨大。 首先是"无限Tab"功能,虽然触发频率较低,但一旦触发,它所带来的感官冲击非常强烈,令人难以不被震撼。仅仅修改了一处地方,多个位置就出现了shadow text,然后一路tab全部应用,只需触发一次就能爱上这个功能。 其次是Chat功能,与之前使用的Zed AI类似,它能够方便地携带各种信息,包括上传的文档、网页、Git仓库、整个文件夹等等。虽然节约的只是复制和粘贴这两个操作,但这两个操作需要重复无数次。如果能够快捷地自动带上当前文件、选中的代码或整个代码库,那么解决的总操作量在高强度使用下每天可达数百甚至上千次。 最后是Composer功能,被大家广泛誉为Cursor杀手级能力。但实际使用下来,体验并不理想。通常简单的任务用不上Composer,而复杂的任务Composer又无法完全胜任。不过,显然这是一个前景可期的功能,随着大模型能力的提高,这个功能只会越来越好用。等到下次像Sonnet3升级到Sonnet 3.5这样的更新再次出现时,Cursor必然会更加强大。当然,类似的功能并非只有Cursor拥有,Aider也提供了相似的功能,是否还有更多类似工具我就没有深入了解了。 总而言之,作为VSCode上的一个"扩展",Cursor完全有能力替代VSCode。不过Cursor的价格是Copilot的两倍,我目前不会选择订阅。它的体验并没有比Copilot好一倍。像自动补全、Chat、Apply以及Codebase的自动上下文等功能,Copilot都做得很好。仅凭多次Tab和一个尚不完善的Composer功能,不值得我多花一倍的钱。
- Xieisabug
- 23 Aug, 2024
大模型-自动编写SecRule规则验证工具
背景 我们有类似waf的攻击检测产品,所以需要测试一些攻击是否能够正确识别,并且识别的原因是否正确,如果是自己去看规则,来编写,几十上百个规则太难了,要搞很久很久,而且是非常无聊的任务 大模型 用大模型来完成这个任务刚好,大模型懂SecRule语法,并且能够理解正则表达式,是干这个活的完美人选。 只要写一个不太烂的prompt约定一下产出的格式,我这里是产出的python代码,然后保存为文件,方便我以后经常调用验证产品。 import pandas as pd import openai import os# 设置OpenAI API密钥和自定义endpoint API_KEY = '' # 替换为您的自定义endpoint API_BASE = ''# 读取CSV文件 input_csv_path = 'input.csv' df = pd.read_csv(input_csv_path)# 创建一个数据目录 output_directory = 'payload_output/' os.makedirs(output_directory, exist_ok=True)# 假设CSV文件中有一列名为'text',我们将对其进行文本生成 generated_texts = []client = openai.OpenAI( api_key=API_KEY, base_url=API_BASE )for index, row in df.iterrows(): print(f"正在处理第 {index + 1} 行... {row.iloc[0]}") prompt = row.iloc[1] # 调用OpenAI的API生成文本 response = client.chat.completions.create( stream=False, model="deepseek-coder", # 选择适当的模型 messages=[ {"role": "system", "content": """ 需要对WAF规则进行匹配测试,所以要根据用户提供的Secrule规则进行python poc的编写。 请使用requests库来进行请求发送,函数名直接命名为attack,在函数的顶部用注释表明该模拟的意图,传入参数为url、cookie,url为模拟攻击网站host,cookie参数如果生成的poc脚本中用到了则拼接在一起,否则直接传递cookie参数,举例如下: ```python # 模拟cookie中超过3个符号 def attack(url, cookie): payload={} headers = { 'Host': 'example.com', 'Cookie': 'TestCookie=-1-1-1-1-;' + cookie, 'User-Agent': 'Jetknown-Test-Case' } response = requests.request("GET", url, headers=headers, data=payload) print(response.text) ``` 仅需输出代码块,不要进行解释和说明,也不要在代码块中引入requests """}, {"role": "user", "content": "规则如下:\n" + prompt + "\n"} ], max_tokens=4000 # 根据需要调整生成文本的长度 ) generated_text = response.choices[0].message.content.strip() print(f"生成的文本:{generated_text}") # 从生成的文件的markdown中提取代码 generated_text = generated_text.split("```python")[1].split("```")[0].strip() generated_text = "import requests \n\n" + generated_text # 将生成的文本保存到文件中 file_name = f"{output_directory}attack_{row.iloc[0]}.py" # 写入文件 with open(file_name, 'w') as f: f.write(generated_text)然后写一个代码来动态引入python文件并且执行 def execute_attacks(directory, url, cookie): # 遍历指定目录中的所有Python文件 for filename in os.listdir(directory): if filename.endswith('.py'): file_path = os.path.join(directory, filename) # 动态导入Python文件 spec = importlib.util.spec_from_file_location(filename[:-3], file_path) module = importlib.util.module_from_spec(spec) spec.loader.exec_module(module) # 检查是否存在attack函数 if hasattr(module, 'attack'): attack_func = getattr(module, 'attack') # 执行attack函数 try: result = attack_func(url, cookie) print(f"执行 {filename} 中的attack函数,结果: {result}") except Exception as e: print(f"执行 {filename} 中的attack函数时出错: {str(e)}") else: print(f"{filename} 中没有找到attack函数")大大减少手写测试用例的工作量,提高测试效率,而且可复用,方便后续持续验证产品。并且如果发现不理想的代码,可以挑出来再让大模型重新生成。

- Xieisabug
- 22 Aug, 2024
工具-Zed AI使用体验
编辑器 从IDE的角度来说,Zed还有很长的发展路径。在使用过程中,我发现作为一个IDE,它还缺失了很多功能,比如Git相关的操作(能展示状态)、数据库查看管理等。不过,如果将Zed作为一个轻量级的编辑器来替代Sublime,它绝对是完胜的。与Vscode相比,Zed确实快了很多很多,没有基于Electron构建这点就自带速度属性了。 作为一个普通编辑器,Zed该有的功能基本都具备。但是在配置方面,它比Vscode更原始,很多配置在Vscode中至少可以通过界面进行,而Zed的配置只能通过JSON文件来完成。 特色AI功能 就是冲着这个AI功能体验的Zed,核心思想是在对话界面把上下文都丢给AIAI回答之后在文件需要修改的地方直接让AI应用刚刚对话里的方案白送的Claude 本来这可以作为Zed的一个加分项,但实际体验下来,发现很容易触发rpm限制。一旦达到限制,Zed送的Claude就报错没法继续用了。不过还好,我们可以使用下面的方法来解决这个问题。 使用Copilot 没错,我们可以直接使用Copilot提供的4o作为聊天工具,它同样具有输入补全的能力。这样既不会浪费之前为Copilot付费的钱,还能获得不错的体验。 配置Deepseek Zed非常适合Deepseek,Zed AI的理念会使用大量的token(很多文件作为上下文),并且在AI应用到文件的时候,会把问答里的内容当做上下文全部带上,Deepseek刚好能够完美hit cache,但需要使用Cloudflare Worker把openai的model转成deepseek coder。以下是转发的示例代码(给个例子,这是我很多转发中的一个): export default { async fetch(request, env, ctx) { const url = new URL(request.url); let pathArray = url.pathname.split("/ds-beta"); if (pathArray.length <= 1) { return new Response('Bad request: Missing `redirectUrl` query param', { status: 400 }); } // 克隆原始请求 let originalRequest = request.clone(); // 读取并打印原始请求体 let originalBody = await originalRequest.json(); console.log("Original request body:", JSON.stringify(originalBody, null, 2)); // 修改 body let modifiedBody = { ...originalBody, model: "deepseek-coder" }; // 创建新的 headers, 复制所有原始 headers let newHeaders = new Headers(originalRequest.headers); // 更新 Content-Type header newHeaders.set('Content-Type', 'application/json'); // 创建新的请求,包含修改后的 body 和所有原始 headers let newRequest = new Request(originalRequest, { body: JSON.stringify(modifiedBody), headers: newHeaders, method: originalRequest.method, }); // 打印修改后的请求体 console.log("Modified request body:", JSON.stringify(modifiedBody, null, 2)); console.log("send request to deepseek"); // 使用修改后的请求发送子请求 let res = await fetch("https://api.deepseek.com/beta" + pathArray[1], newRequest); console.log("receive response from deepseek", res.statusText); return res; }, };感受 换用了一个简单的IDE后,在编写简单项目的时候,感觉更加专注了(可能这就是为什么那么多人喜欢使用Vim的原因吧)。它带来了一种编写代码的快感(??)。 Zed支持Vim模式、多光标编辑、代码跳转,可以使用Copilot,AI功能在某些情况下非常给力。通过JSON配置task后,使用起来非常便捷。它确实非常非常快,并且支持大多数常用的编程语言。 不过,Zed的Git管理需要通过命令行进行,没有直观的图形化配置界面,它的插件支持也非常有限。
2024年中AI感悟
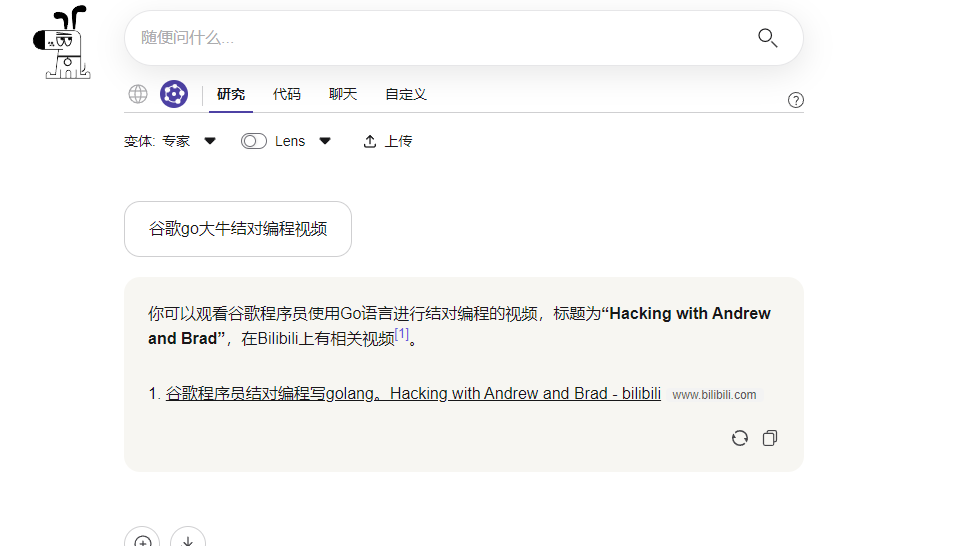
现在是2024年6月29日,自ChatGPT发布(2022年11月30日)已经过了1年半,时间过得好快,而且AI发展进化得好快。 这一年半,我粗略统计了我的消费,直接花在AI上大约4000块。组成结构大概包含:包月的AI服务2-3个,20刀一个月,大模型API 1000人民币不到,用于日常工具和开发研究。包月的AI服务比如Github Copilot、Poe、ChatGPT Plus,还有最近的Kagi,API包含OpenAI中转商、国内的零一、Deepseek。这几千块钱也许是我花的最值的自我投资,通过这些AI工具让我的个人效率10倍的提升,可以说飞升成为100x程序员了【1】。 在使用AI并且研究AI的这段时间里,我也有了一些感悟,想记录分享一下,写的比较乱,想到啥写啥了。 会用AI的人,与不会用AI或者不用AI的人拉开更大的差距 这个观点算是老生常谈了,例如之前redis的作者antirez也提到过。从过去的关键字搜索转变到自然语言构建Prompt,甚至是用英语构建Prompt,这个转变很多人无法适应。但从ChatGPT发布开始,规则就在一瞬间转变了。 过去擅长从问题中提取关键字的人,现在要开始善于将问题描述的越来越详细。相信这难不倒过去善于使用传统搜索引擎的人,但没有理解现在AI运作原理的人或者思维没有转变的人,使用AI通常无法获得理想的效果,举个例子,我见到有人这样询问AI:"Java 洗牌",说不好他是懒还是不明白如何使用AI,在传统的搜索引擎时代也许搜索引擎会根据这个关键字给你匹配一系列的结果,然后你去挑一篇文章看。但AI时代如果这么去问问题有一定的概率AI会对你胡言乱语,并且大概率给你的东西你没法直接用,如果要得到更好的结果,在描述的过程中可能需要给出更多的上下文和要求:”请用Java编写一段用于洗牌的算法,要求不修改原来的数组返回一个新数组“。这样AI就能直接生成一段你直接能够复制粘贴的代码,然后再要求AI:”为这段代码生成3个corner case的JUnit5测试用例。“来进行单元测试。 搜索是最接地气的AI使用场景,我已经为AI搜索开始付费了,它为我带来了什么提升呢?举一个我现实碰到的情况,在群里吹水时突然提到了几年前我看的一个编程视频,但是我没有保存链接,这个时候我用AI搜索:如果我使用的是传统的搜索,那么搜索的情况是如下:根本无法找到我想要的那个视频,但是AI搜索却能够理解我的意思并且精准的找到了对应的视频(虽然也是依赖于Kagi高质量的搜索结果)。 我无法估计通过AI搜索为我节省了多少时间,也无法估计我写的AI小工具能够提高我多少效率,更无法统计如果没有AI的帮助我会少学习到多少知识,但剥夺了AI我的工作和学习会非常不习惯,就像突然回到现金支付的社会一样。 AI还是要依赖基础设施 在刚刚聊搜索的时候,聊到了Kagi的AI搜索厉害最重要的还是基于Kagi自己搜索的高质量结果集,这很能体现AI产品的特点,那就是基础设施决定了AI的能力下限。 Perplexity说要替代Google成为新时代的搜索引擎,但其实它底层使用的还是Google提供的搜索API,只要Google不让它使用API了,它只能切换到Bing或者别的搜索引擎,那么它的能力大概率会降低。所以它说要取代Google基本上是不可能的,Google要赶上它的AI总结能力很简单,但是它要超过Google的搜索能力难度就堪比登天了。 不需要基础设施的应用应该就只有聊天系和生成系,这完全是靠大模型自己的能力,但是单纯这两种场景的应用场景太有限了,要能作为产生价值的工具,基本是依靠大量的基础设施来完成的。 比如PPT生成,AI目前的能力只能为PPT生成大纲、PPT中的文字、PPT中的图片,像是PPT的排版、格式调整、动画效果都需要用模板来实现,最多让AI进行选择哪个模板更适合演讲主题;再比如网站生成,AI并没有能力为你生成一整个网站,它最多为你生成一个”网页“而且并不完美,AI网站生成大部分的能力都来自非AI时代时这些网站生成网站积累的模板再加上AI的文字和图片生成的能力。 现在很火的Agent,也需要实现非常多的基础设施能力。这些能力提供给AI后,AI可以帮我们实现自动化操作这一步,所以我认为不管是想要创业还是想要用AI进行赋能的人,先搞好基础设施,再把AI加到基础设施里。 不一定必须用到最强的智能 是否产品一定要使用当前最聪明的人工智能?根据产品的形态其实是不需要的,经过特定任务微调的小模型在某些场景下一样可以发挥出SOTA模型的能力。 比如说情感识别或者错别字检测,都不一定要用到GPT4o或者Cluade3 Opus来完成,使用小型模型能在百分之一成本下同样高质量的完成任务。 但这些都属于降本了,在产品开发验证完PMF之后,才需要进行降本,也就是李开复老师提到过的TCPMF,technology cost product market fit,产品和市场契合,再去寻求技术成本的契合。个人理解的PMF只是产品能够向前跑的验证,能跑多远可能就要看TCPMF了,健康的盈利才是可持续发展的。 产品不追求最强的智能还有一个好处,能够利用上开源的模型进行本地部署。在许多需要数据安全的行业,不希望自己的很多隐私信息被发送到大模型厂商处,第一是绝大多数的大模型厂商都会在使用条款里说明自己有权利拿用户数据来进行大模型训练(国内厂商大多都是),更有厂商会无视用户的隐私和版权使用数据来进行模型训练(就是说的那个不敢Open的AI);第二是这些数据有时候涉及到商业机密,就算不被用于模型的计算,但在公网上通过大模型对于这些商业机密进行一系列的处理也是增加了很多的风险(并且大模型也是能够进行一些注入攻击的,如果恰好程序里有一些函数调用能力,那么有可能就会导致商业机密泄露)。而且云厂商的API费用有时候不比自己购买硬件+电费来的便宜,对于需要巨大token用量的场景,本地部署甚至能省钱。 预研要用比SOTA模型更强的假设来做 是否产品研发就按照大模型的能力边界来进行呢?大模型的发展速度太快了,做研究一定要用现在最强模型的能力或者超越它的能力来进行假设,否则研究很快就过时,因为模型的发展大大超过想象,现在已经有开源大模型的能力可以追赶上去年GPT-4 turbo的水平了,也就意味着去年用GPT4t做研发的产品,已经完全可以进行本地部署了。同样我们可以展望,未来也有4o级别的本地模型,让我们来进行多模态的开发。 所以现在的产品想象力,可能需要最少在4o的基础上来进行,甚至把这个水平拉到4o之上去想象。这个想象可以是多个维度的,比如成本,如果token不要钱了,产品可以如何设计?又比如速度,假如以后得输出都像groq一样1000t/s,产品又会出现什么变化?再比如维度,现在基本是语音、文字、图片,假如以后增加视频甚至一些更加底层的端到端如电信号到控制向量,这时候产品又如何来设计? 用Github Copilot举例,是否在token够便宜大模型上下文够长的时候,全量的代码和数据库设计是每次都包含在上下文中的,这样能够让大模型在每次对话的时候都能理解代码中全部细节,而不需要像现在这样费心费力的去选中代码或者RAG;如果速度够快了,是否可以让大模型互相讨论生成的结果10次,来获取更加完善正确的结果再进行返回;如果维度增加了,是否可以端到端的“语音输入”到“VSCode操作输出”,从而达到Copilot全权控制我的VSCode,而我说话只要告诉大模型我的需求。 同样现在被人诟病的幻觉情况也是一样,按照假如幻觉是可以控制开关的情况来设计是最好的。 利用幻觉 为什么我要说幻觉要控制开关? 我隐约记得在一本书中看过这种理念,“不要对抗自己的负面情绪,而是要利用它“,每个人都有懒惰、欲望之类的负面情绪,如何正确的去利用它而不是对抗它,会让你从痛苦变为幸福。比如我可以在我抗拒学习的时候,促使我进行运动;我可以在我想吃肉的时候,为我的工作设立一个高目标并且奖励自己一顿烤肉,从而让我更高效更有动力的去完成工作。 大模型有幻觉的特点,并且还有两个参数温度和topk用于控制回答的多样性,但就算是把温度设置为0,topk设置为最小,也不会让大模型完全没有幻觉。幻觉和回答的多样性不同,幻觉是在大模型不知道某事的时候,认为自己知道而进行的胡言乱语。但如果把幻觉当成模型的想象力,那大模型就很有可能迸发出许多不一样的能力。 在许多需要“创造力”的领域,利用大模型的幻觉可以进行充分的想象,有时候是超越了“想象”的想象,因为大模型自己也不知道它胡言乱语的什么,比如下面的问题,如果是你你会如何回答?在类似角色扮演、写作、头脑风暴,甚至是一些特殊的研究领域,这种不走寻常路的胡言乱语经常可以给用户一种富有创造力的错觉。 目前的AI要替代人类还早,想想无人驾驶 每当科技向前推进一步的时候,都会有替代人类、失业之类的论调,甚至总是有人为了炒作热度而把新事物的出现与工业革命相提并论。但AI这次不一样,它是真真实实影响到了人类,也可预见的会像工业革命一样会让社会产生变革,从工业社会转变为全自动化生产社会,将生产力再次提高一个数量级。 但是,是现在吗?自动驾驶L2发布多少年了,也一直有以后不需要司机的论调出现(我甚至一度收到这种言论的影响而懒得去练车),而近两年才真正的开始真的无人的士(但还是需要安全员),最近特斯拉的FSD似乎比之前的自动驾驶有很大的进展,也许马上就真的不会有司机甚至汽车都不会有驾驶位。 在某次直播中,有位程序员大佬说了“你在工作中用过AI就知道了,AI目前不可能替代人类编码,AI很难根据你的描述来生成完全符合你要求的一个复杂的程序,要做到这些,需要定义一种语言,让计算机严格按照你的指示来做,但那其实就是编程,你还是需要编程”。目前看来很有道理,AI确实暂时威胁不到程序员,因为AI能力的天花板很容易看见,他目前能做到高中的智力水平以及囊括极为广泛的知识和无限的体力,如果某些工作只需要这样就能做,那么就很有可能被AI替代。 这样的工作多吗,非常多。首当其冲的是不需要智力的工作,诸如配音、录入信息、填表、分类等等,这些只要有识字级别的知识水平加上简单的教学就能上岗;其次是需要一些简单的领域知识,但是又无需太过高级的智力去做决策的,如各种客服人员、财务律师医生等职业的助理人员等等;再往高级一些就是需要碾压用户的智商才能胜任的工作,比如中小学教师、市场分析人员、销售人员等,这些职业在某些特定的情况下,面对的用户可能有信息或者智力差。再要更高级,就已经达到了当前AI的能力边界了,目前来说大部分的程序员都无需担心,AI的能力在测试集上都无法达到100%解决问题,何况现实的业务更加复杂。 那么我举例的职业里,真的都被淘汰了吗?当然没有淘汰,使用AI去淘汰这些职业是需要理由的,AI如果能够做到比他们更好更便宜也许是会慢慢进行淘汰的,但目前AI的问题还没有解决。 在AI如此高速发展的两三年里,可以预想到未来肯定是会将这些:简单的、重复的、需要大量人力去做的工作用AI去代替的。也可以预想到再更久的将来,一定会代替更需要智力的高级工作。我们也不应该感到焦虑,马车夫失业了会有司机,司机失业了也肯定会有更高级的职业,Midjourney让部分画师失业,也让部分Prompt Engineer获得工作,保持跟进才是我们应该做的。 【1】10x程序员的概念可以参考这篇文章http://antirez.com/news/112,在这个基础上再提升10x,就成为了100x程序员。
[译]2024年初回顾大语言模型与编程(作者:antirez,Redis作者)
redis作者博文,因为网上看到了很多译文我都觉得差强人意,所以我决定自己来翻译一下,原文:LLMs and Programming in the first days of 2024,采用ChatGPT翻译我进行校对和意译的方式。首先我得说,这篇文章不是对LLMs(大语言模型)进行复盘,很明显再怎么强调2023年对人工智能很特别已经没多大意义。实际上,这篇文章更像是分享我作为程序员的亲身体验。从ChatGPT面世,到后来在本地运行的LLMs,我深入的使用了这项新技术。最初的目标是加快我的编码能力,但这不是唯一的目的。我还想避免浪费精力和时间在编程中那些不值得操心的地方。比如:花无数小时在寻找奇怪又让人提不起兴趣的文档上;努力学习一个过于复杂得没有必要的API;编写一些用一会就会扔的程序。这些都是我不想做的事情,尤其是现在,谷歌已经成了一个充满垃圾信息的海洋,只能在其中寻找少数有用的东西。 不过,我绝对不是编程的新手。我能够在没有任何帮助的情况下写代码,而且也经常这样做。不过随着时间的推移,我开始越来越多地使用LLMs来编写高级代码,特别是在Python中,而在C语言中则较少。个人的经验告诉我,我已经学会了何时使用它们,以及它们什么时候会拖慢我的步伐。我还搞明白了,LLMs有点像 百度百科 维基百科和 Bilibili YouTube上散布的视频课程:它对那些有意愿、有能力和自律的人有帮助,但对那些已经掉队的人来说帮助有限。我担心至少在最初阶段,它们只会使那些已经具有优势的人受益。 所以让我们一步步来看吧。 全知全能还是鹦鹉学舌? 在这个崭新的机器学习浪潮中,最令人担心的一点是,很多人工智能专家难以承认他们知识的局限性。人类发明了神经网络,更重要的是,发明了自动优化这些网络参数的算法。我们的硬件已经可以训练越来越大的模型了,并且通过统计数据(先验知识)和大量的尝试和错误,找到了比其他模型更好的架构。但总的来说,神经网络还是很难搞懂的。 面对LLMs的一些新功能,我们理解不了,本该更谨慎。但许多人严重低估了LLMs,说它们最多就是个稍微高级点的马尔科夫链,能做的也就是重复训练集里的内容。然后,一旦有了证据,这种鹦鹉学舌的观点就被普遍撤回了。 与此同时,有些人过分夸大了LLMs的能力,归功于它们有超自然的能力,但实际上并不存在。不幸的是,LLMs最多只能在它们训练过程中接触到的数据表示的空间里进行填充:虽然这已经很厉害了。实际上,它们的填充能力是有限的(但还是很惊人的)。如果今天最大的LLMs能在它们所接触到的所有代码空间里进行平滑填充,即使它们不能创造真正的新东西,也足以取代99%的程序员了。但实际情况要谨慎得多。LLMs确实可以编写它们之前没以精确形式见过的程序,显示出训练集中以某种频率出现的不同思想的一定能力。但很明显,这种能力现在还有很大的限制,每当需要微妙的推理时,LLMs都会遭遇灾难性的失败。不过,它们代表了人工智能从诞生到今天的最伟大成就。这点似乎是毋庸置疑的。 愚蠢但无所不知 确实,LLMs最多只能进行基础的推理,而且往往不太准确,常常会有些关于不存在事实的幻觉。但它们拥有大量的知识。在编程领域,以及其他有高质量数据的领域,LLMs就像是知道很多事情的愚蠢的学者。和这样的伙伴一起进行结对编程简直是噩梦(对我来说,结对编程本身在任何情况下都很糟糕):他们可能会有一些荒谬的想法,我们得不断地努力推动自己的思路。但如果这个博学的傻瓜能够顺从我们的指导,回答我们提出的问题,情况就会不同。现在的LLMs并不能带我们超越已知的路径,但如果我们想解决一个我们不太熟悉的问题,它们通常能够帮助我们从一无所知到拥有足够的知识来自己解决问题。 在编程这一领域,也许二三十年前,LLMs的能力几乎不会引起任何兴趣。那时候,你只需要懂几种编程语言、掌握经典算法,还有那十个基本的库。其他的东西,你需要依靠自己的智慧、专业知识和设计技能来完成。如果你具备这些条件,你就是个能胜任几乎所有任务的专业程序员。随着时间的推移,我们目睹了框架、编程语言以及各种库的蓬勃发展。这种复杂性的激增通常是不必要的,也不合理,但事实就是如此。在这种情况下,一个知晓一切的傻瓜成为了宝贵的合作伙伴。 举个例子:我进行了至少一年的机器学习实验,使用的是Keras。后来由于各种原因,我转向了PyTorch。我已经了解了嵌入层和残差网络的概念,但我不想像之前学习Keras那样(当时还没有ChatGPT),一步步研究PyTorch的文档。有了LLMs,用Torch写Python代码变得非常简单。我只需要对我想构建的模型有一个清晰的理念,然后提出正确的问题。 实际操作时间 在实际操作中(我说的不是那些简单的事情),比如:“嘿,X类的Y方法是什么?”如果只是这样的话,人们可能会更倾向于怀疑LLMs的价值。LLMs可以做的事情要复杂得多。直到几年前,这还像是纯粹的魔法。我可以告诉GPT4:“看,这是我在PyTorch中实现的神经网络模型。这些是我的批次数据。我想调整张量的大小,以使它们与神经网络的输入兼容,还要以特定的方式表示数据。你能为我生成相应的代码吗?”GPT4会生成代码,我所要做的就是在Python命令行界面测试一下张量是否真的具有对我有用的尺寸,以及数据布局是否正确。 另一个例子。不久前,我需要为某些基于ESP32的设备实现一个BLE客户端。经过一番研究,我意识到多平台的蓝牙编程绑定或多或少都不可用。解决方案很简单,就是使用macOS的原生API,用Objective C编写代码。所以,我发现自己同时面临着两个问题:一方面是学习Objective C繁琐的BLE API,充满了我认为毫无意义的代码模式(我是个极简主义者,那种API正好与我认为的“好设计”背道而驰),另一方面是要记住如何用Objective C编程。我上次用Objective C编写程序已经是十年前的事了:我不记得事件循环、内存管理等细节了。 最终,我得到了这段代码,虽然它不太优雅,但它完成了我需要的任务。我在极短的时间内编写了它。没有LLMs,这几乎是不可能的。 https://github.com/antirez/freakwan/blob/main/osx-bte-cli/SerialBTE.m 这段代码主要是通过在ChatGPT上剪切和粘贴我想做的但不太了解如何实现的内容来编写的,所以它并没有完全正确运行。但LLMs告诉我了问题所在以及如何解决。当然,LLMs并没有完全编写整段代码,但它显著加速了编写过程。没有ChatGPT我能做到吗?当然可以,但最有趣的是,它会花费我更多的时间,而且我甚至可能不会尝试,因为那不值得。这一点至关重要。对于我的项目来说,编写这种程序的工作量与回报之比是不划算的。而且,这项工作还带来了更有用的次要效应:在那个项目中,我修改了linenoise(我的一个用于行编辑的库),使其能在多路复用中工作。 还有另一个例子,这次涉及更多的是数据解释而不是代码编写。我想使用我在网上找到的一个卷积神经网络来设置一个Python脚本,但它的文档相当缺乏。这个网络的一个优点是它采用了ONNX格式,因此我可以轻松地提取输入和输出列表以及它们的名称。我只知道这个卷积网络有一点:它可以在图像中检测某些特征。我不知道输入图像的格式和大小,尤其是网络的输出比我想象的要复杂得多(我以为它是一个二元分类器:观察到的图像是正常,或者有问题。本应该只有两种输出,但实际上有数百个)。我开始将ONNX网络的元数据输出复制粘贴到ChatGPT中,并向助手解释了我对网络的一些了解。ChatGPT推测输入是如何组织的,输出可能是标准化的框,指示图像中与潜在缺陷相对应的部分,以及其他指示这些缺陷可能性的输出。经过几分钟的来回对话,我得到了一个能够进行网络推理的Python脚本,以及将起始图像转换为适合输入的张量所需的代码等等。让我印象深刻的是,一旦ChatGPT在测试图像上观察到了原始输出值(基本上是logits),它最终“理解”了网络的功能:一系列浮点数提供了上下文来确定确切的输出细节,标准化,框是否居中,或者是否指定了左上角等等。 一次性程序 有很多类似我刚刚提到的例子,虽然细节有所不同,但故事基本一样。当我遇到问题需要迅速获取验证性信息时,我会求助于LLMs,以确保它们提供的信息是可靠的。在这些情况下,我使用LLMs来快速填补我的知识缺口。 然而,在其他情况下,我会让LLM编写所有代码。例如,当我需要创建一个几乎是一次性的程序时,就像这个: https://github.com/antirez/simple-language-model/blob/main/plot.py 我需要可视化一个小型神经网络学习过程中的损失曲线。我向GPT4展示了PyTorch程序在学习过程中产生的CSV文件格式,然后询问如果我提供多个CSV文件的路径,我想比较它们的验证损失曲线,而不是同一实验的训练和验证损失曲线。GPT4生成了上述结果,整个过程只花了三十秒。 同样,我需要一个程序来读取AirBnB的CSV报告,并按月和年对我的公寓进行分组。然后,根据清洁费和每次预订的晚数,它会计算不同月份的平均租金价格。这个程序对我来说非常有用,但编写它又极其无聊。所以,我只复制粘贴了CSV文件的一部分到GPT4中。我告诉LLM要解决的问题是什么:程序第一次尝试就成功了。下面是完整的代码: import pandas as pd pd.set_option('display.max_rows', None) df = pd.read_csv('listings.csv') reservations = df[df['Type'] == 'Reservation'] reservations['Start Date'] = pd.to_datetime(reservations['Start Date']) reservations['Year'] = reservations['Start Date'].dt.year reservations['Month'] = reservations['Start Date'].dt.month reservations['Nightly Rate'] = (reservations['Amount'] - reservations['Cleaning Fee']) / reservations['Nights'] all_listings = reservations['Listing'].unique() all_years = reservations['Year'].unique() all_months = range(1, 13) index = pd.MultiIndex.from_product([all_listings, all_years, all_months], names=['Listing', 'Year', 'Month']) all_data = pd.DataFrame(index=index).reset_index() merged_data = pd.merge(all_data, reservations, on=['Listing', 'Year', 'Month'], how='left') average_nightly_rates = merged_data.groupby(['Listing', 'Year', 'Month'])['Nightly Rate'].mean().fillna(0) print(average_nightly_rates)要理解如何对这些混乱的数据进行分组,需要一些简单的推理能力,这不是LLMs能通过简单地复述已知语言来解决的问题。虽然GPT4在训练中可能遇到过类似的问题,但几乎可以肯定它没有见过要按照我指定的精确方式在特定格式的CSV文件中进行分组的程序。这展示了在我看来,LLMs可以在不同程序之间进行一定程度的填充,处于训练集所绘制的程序空间内。 对我来说,编写这些程序是不明智的时间投资。LLMs可以以相当直接的方式为我生成代码,无疑提高了我的工作效率,让我可以更专注于更重要的任务。 事与愿违:系统编程 虽然我在LLMs和编程方面都有一些成功经验,但每当我写C程序的时候,我基本上都只是把LLMs当作更方便的文档工具。我是系统编程方面的专家,在这个领域除非LLMs能够进行复杂的推理,它们对我才有用。但很遗憾,通常情况下它们都不能满足我的需求。 好了,现在让我们来看一下这个实验的要求吧: 首先,你需要概述一个高效的C语言布隆过滤器的实现要求,要求这个过滤器是小巧但功能强大的。特别关注哈希函数的设计和性能。然后,你需要以高质量的C代码来实现这个过滤器。 另外,需要考虑到你的示例实现要能够存储100,000个元素,并且假阳性概率最多不超过5%。这些元素都是以null结尾的字符串。 以下是LLMs的输出: #include #include #include #include #define N 100000 // 元素数量 #define P 0.05 // 误报概率 #define M (int)(-(N * log(P)) / (log(2) * log(2))) // 位数组大小 #define K (int)(M / N * log(2)) // 哈希函数数量 unsigned char bitArray[M / 8 + 1]; void setBit(int n) { bitArray[n / 8] |= 1 << (n % 8); } int getBit(int n) { return bitArray[n / 8] & (1 << (n % 8)); } // 基本哈希函数(仅用于演示) int hash1(char *str) { int hash = 5381; int c; while ((c = *str++)) hash = ((hash << 5) + hash) + c; return abs(hash % M); } int hash2(char *str) { unsigned long hash = 0; int c; while ((c = *str++)) hash = c + (hash << 6) + (hash << 16) - hash; return abs(hash % M); } void add(char *str) { setBit(hash1(str)); setBit(hash2(str)); // 如果需要,添加更多的哈希函数 } int is_in(char *str) { return getBit(hash1(str)) && getBit(hash2(str)); // 如果使用更多的哈希函数,请检查它们 } int main() { char *testStr = "testString"; add(testStr); if (is_in(testStr)) { printf("%s 可能在集合中。\n", testStr); } else { printf("%s 肯定不在集合中。\n", testStr); } return 0; }GPT-4生成的实现并不完美。布隆过滤器在数据结构中相当常见,不算什么特别的东西。不过,毫无疑问,要编写一个像样的布隆过滤器需要更高级的思维能力。比如,要找到一种有效地对同一个字符串进行N次哈希处理的方法,同时要确保这些哈希值之间没有关联。 但是,如果你明确要求GPT-4来修改哈希函数,以产生N个没有关联的输出,那么它提出的解决方案可能更加可行: unsigned int hash(const char* str, unsigned int hash_id) { unsigned int hash = 5381; int c; while ((c = *str++)) { hash = ((hash << 5) + hash) + c + hash_id; } return hash % BF_SIZE; }如果GPT-4能够自己想到这个主意,那它就会以一种不同的方式来编写布隆过滤器,一次性设置K个比特,只用一个哈希函数。 GPT-4能够独立完成编写合适且更通用的哈希函数的任务。但在编写布隆过滤器这个更大的项目中,它未能展现出足够的逻辑推理能力,而是生成了两个不同但相似的哈希函数,这与人们对于布隆过滤器的预期有些不符,但这在关于布隆过滤器的糟糕文章示例中并不罕见。 目前大型语言模型在推理方面仍有待加强,再加上关于这个主题的资源可能相对有限,甚至可能存在很多低质量的资源,这都导致了成果相对有限。但这并不是个例。我在尝试使用LLMs进行算法或系统编程时,通常结果都不太理想,即使期望LLMs在像Python编程这样的上下文中拥有的能力也并不一定能够完全体现出来。 同时,GPT-4能够解析它生成的函数(在另一个会话中),也能精确理解其目的: https://chat.openai.com/share/f54b64d7-d19a-4be4-8f10-08553aa812f1 因此,声称在系统编程上下文中没有用处是肯定不准确的。 有趣的是,这些情况下,小型大语言模型和大型大语言模型之间的差异确实显著。让我们来看看两个本地模型的表现。 例如,Mistral的MoE Mixtral,对同一个问题的回应如下: unsigned int hash(const char* str, unsigned int hash_id) { unsigned int hash = 5381; int c; while ((c = *str++)) { hash = ((hash << 5) + hash) + c; } return hash + hash_id; }显然,只是在末尾加上一个 hash_id 是一个相当差的解决方案。Mixtral 在许多情况下都表现出色,但对于本来就不太强的LLMs来说,规模似乎是关键,越大越好。 我与本地的 LL 模型 deepseek-coder 进行了对话,它的规模仅有 4 比特,因为我的 RAM 不够用来更高精度的模型。但是,作为一个拥有 340 亿参数的大型模型,它在这个问题上的推理能力似乎相当先进。以下是聊天记录(使用 llama.cpp 运行):我有一个哈希函数,本应该为相同的数据输出 N 个不同的哈希值。然而,当我改变 hash_id 的值时,我发现生成的哈希值分布非常不均匀: unsigned int hash(const char* str, unsigned int hash_id) { unsigned int hash = 5381; int c; while ((c = *str++)) { hash = ((hash 也许我使用的加盐策略不够好?我该如何改变它?你的实现可能存在一个问题,就是你只是简单地将 hash_id 添加到哈希值的末尾。这可能会导致分布不均匀,特别是如果 hash_id 太大或者分布不均匀的话。 考虑使用位操作来混合 hash_id。以下是一个使用异或运算的示例: unsigned int hash(const char* str, unsigned int hash_id) { unsigned int hash = 5381; int c; while ((c = *str++)) { hash = ((hash 这样做将会更好地将 `hash_id` 分散到你的哈希值中,而不像简单地添加它那样可能导致分布不均匀。【省略...实际回答包含了更多信息】。 Deep-seek coder reply作为运行在我的MacBook M1 Max上的模型来说,效果还不错。这个模型在处理求和和XOR混合的问题上表现出色。在这种情况下,模型肯定是受到了我提供的问题线索的帮助,但它也能够嗅出实际问题并提供一些有用的替代方案。像上面的这种情况,书籍、文档或谷歌搜索都无法提供帮助。无论你怎么看待LLMs,不管是它是基于填充的原始输出,还是以其他方式呈现,这个模型都已经做了某种程度的推理工作。如果我们承认在这种情况下它能够找到问题的根源并提供潜在解决方案,那么说LLMs对程序员毫无用处,那未免太武断了。 然而,最近几个月的经验告诉我,在系统编程方面,如果你已经是一位有经验的程序员,那么大型语言模型(LLMs)几乎不会提供可行的解决方案。让我给你分享一个真实的例子。我正在进行的项目叫做ggufflib,涉及编写一个读写GGUF格式文件的库,这是llama.cpp加载量化模型时使用的格式。一开始,我尝试使用ChatGPT来理解量化编码的工作原理(因为每个量化位都以独特的方式存储,以提高速度)。但后来我决定采用逆向工程的方式来研究llama.cpp的代码,因为这种方法更加高效。如果LLM能够像识别数据编码的“struct”声明和解码函数一样,帮助系统程序员重新构建数据格式文档,那将非常有用。llama.cpp中的函数非常小,可以完全包含在GPT-4的上下文中,但LLM的输出毫无帮助。在这些情况下,情况回到了传统的方式:拿出纸笔,仔细阅读代码,然后查看解码器提取的位是如何映射的。 如果你有兴趣的话,可以看看我更详细地解释上述情况,你能容易地理解并尝试它。我们有一个数据结构,是从llama.cpp中实现的: // 6-bit quantization // weight is represented as x = a * q // 16 blocks of 16 elements each // Effectively 6.5625 bits per weight typedef struct { uint8_t ql[QK_K/2]; // quants, lower 4 bits uint8_t qh[QK_K/4]; // quants, upper 2 bits int8_t scales[QK_K/16]; // scales, quantized with 8 bits ggml_fp16_t d; // super-block scale } block_q6_K;并且有一个用于执行反量化的函数: void dequantize_row_q6_K(const block_q6_K * restrict x, float * restrict y, int k) { assert(k % QK_K == 0); const int nb = k / QK_K; for (int i = 0; i < nb; i++) { const float d = GGML_FP16_TO_FP32(x[i].d); const uint8_t * restrict ql = x[i].ql; const uint8_t * restrict qh = x[i].qh; const int8_t * restrict sc = x[i].scales; for (int n = 0; n < QK_K; n += 128) { for (int l = 0; l < 32; ++l) { int is = l/16; const int8_t q1 = (int8_t)((ql[l + 0] & 0xF) | (((qh[l] >> 0) & 3) << 4)) - 32; const int8_t q2 = (int8_t)((ql[l + 32] & 0xF) | (((qh[l] >> 2) & 3) << 4)) - 32; const int8_t q3 = (int8_t)((ql[l + 0] >> 4) | (((qh[l] >> 4) & 3) << 4)) - 32; const int8_t q4 = (int8_t)((ql[l + 32] >> 4) | (((qh[l] >> 6) & 3) << 4)) - 32; y[l + 0] = d * sc[is + 0] * q1; y[l + 32] = d * sc[is + 2] * q2; y[l + 64] = d * sc[is + 4] * q3; y[l + 96] = d * sc[is + 6] * q4; } y += 128; ql += 64; qh += 32; sc += 8; } } }如果我要求GPT4来给我写一个关于使用的格式概述,那真的是有点难懂,特别是在解释了如何根据权重位置在“ql”中存储下/上4位块的部分。为了这篇博客文章,我还试着叫它写一个简单的函数,展示数据是如何存储的(或许它不能用文字来解释,但可以用代码)。生成的函数在很多方面都存在问题,包括索引错误和将6位扩展到8位的符号扩展错误(实际上只是转换成了uint8_t),等等。 可以顺便看看,这是最终我自己编写的代码: } else if (tensor->type == GGUF_TYPE_Q6_K) { uint8_t *block = (uint8_t*)tensor->weights_data; uint64_t i = 0; // i-th weight to dequantize. while(i < tensor->num_weights) { float super_scale = from_half(*((uint16_t*)(block+128+64+16))); uint8_t *L = block; uint8_t *H = block+128; int8_t *scales = (int8_t*)block+128+64; for (int cluster = 0; cluster < 2; cluster++) { for (uint64_t j = 0; j < 128; j++) { f[i] = (super_scale * scales[j/16]) * ((int8_t) ((((L[j%64] >> (j/64*4)) & 0xF) | (((H[j%32] >> (j/32*2)) & 3) << 4)))-32); i++; if (i == tensor->num_weights) return f; } L += 64; H += 32; scales += 8; } block += 128+64+16+2; // Go to the next block. } }从那个函数中,我删掉了一些实际贡献的东西:一大堆长长的注释,详细记录了llama.cpp中Q6_K编码所使用的确切格式。现在,如果GPT可以帮我来做这个任务,那真的会非常有帮助,我敢说这只是时间的问题,因为这种任务是可行的,无需任何重大突破,只需要一些改进。 正确认识问题 真的很抱歉,但实际情况如下:现在的大部分编程工作都是在稍微不同的情境下反复执行相同的任务。这些任务通常不需要太多的推理能力。虽然LLMs在这方面表现得相当出色,但它们仍然受到它们上下文的最大尺寸的限制。这应该让程序员们深思,编写这种类型的程序是否值得呢?当然,你会得到相当丰厚的报酬,但也许在未来五到十年内,LLM可以完成其中的一部分工作,这是否仍然是最佳选择呢?(译注:我看到作者的评论区对他的这一观点展开了激烈的讨论,讨论核心是作者在劝说程序员改行,我认为作者只是在让程序员们停止进行没有意义的工作而去寻找更有意义的,大家也可以发表自己的看法) 此外,LLMs是否真的具备某种推理能力,还是一切都只是虚张声势呢?也许有时候,它们似乎只是因为符号学家会谈到的"能指"而给人一种实际上并不存在的深层含义。那些与LLMs密切合作的人,尽管了解它们的局限性,但他们确信LLMs不可能仅仅是虚张声势:它们在模仿以前见过的内容方面表现出了惊人的能力,远超过了简单的随机单词重复。尽管它们在大部分时间里是通过预测下一个标记来进行训练的,但这个目标迫使模型构建某种抽象模型。虽然这个模型可能不够强大、有缺陷且不完美,但如果我们观察到的世界就是这样,那么这个模型必然存在。当我们的数学定理不够可靠,即使是最顶尖的专家们也会持不同的观点时,相信我们亲眼所见似乎是一个明智的选择。 最后,如今在编程中不使用LLMs还有意义吗?提出正确问题给LLMs是一项基本技能,这项技能练习得越少,通过人工智能提高工作质量就越困难。此外,提高对问题的清晰描述能力也对与他人沟通非常有用。有时,不仅仅是LLMs,其他人也难以理解我们要表达的意思。沟通困难是一个很大的限制,尽管许多程序员在自己的领域非常擅长,但他们的沟通技巧不足。甚至将LLMs仅用于文档的压缩形式也是个不错的主意,现在连谷歌都在这方面遇到了困难。对我来说,我将继续广泛使用它们。我从来没有喜欢过学习晦涩的通信协议细节或编写复杂库的方式,那只是浪费时间。对我来说,这些都是"垃圾知识"。LLMs越来越多地帮助我摆脱这些烦恼。